


はじめに
こんにちは、AWS Japan でソリューションアーキテクトをしているいなりくです。
2026 年 9 月、AWS News Blog で Nx Plugin for AWS v1.0 が紹介されました。
自然言語で依頼すると、Coding Agent が React、API、データベース、認証、IaC を組み合わせてくれる。ここまでは記事から分かります。
一方で、私が最初に読んだときは次の点が分かりませんでした。
- なぜ普通のテンプレートではなく Nx なのか
- Coding Agent は何を考えて、何を実行しているのか
-
connectionジェネレーターは、本当にアプリ同士を接続するのか - 生成後にどこまで動き、何を自分で実装する必要があるのか
- AWS Blocks や Amplify Gen 2 とは何が違うのか
そこで今回は、単なる Welcome 画面ではなく、フィードバックの登録・一覧・ステータス更新ができる Feedback Triage Board を実際に作りました。

図1: 完成した Feedback Triage Board
React から tRPC API を呼び、DynamoDB Local に保存します。生成コードと Project 間の依存関係に加えて、CDK synth、Checkov、AWS へのデプロイまで確認しました。
Nx Plugin for AWS の価値は「プロンプトだけで完成したアプリが出てくること」ではありません。
レビュー済みのジェネレーターが、実装・ローカル開発・IaC の共通部分をまとめて用意します。そのうえで複数プロジェクトの依存関係と実行順を Nx のグラフへ載せられる点がいちばん大事になります。
今回作ったもの
チームに届いたフィードバックを整理する小さなボードを作りました。
- タイトル・説明・カテゴリ・優先度を入力して登録
- 登録済みフィードバックを新しい順に表示
-
New、In progress、Resolvedへステータス変更 - 全件数、未完了件数、完了件数を集計
- DynamoDB Local へ保存
Generator が用意した部分へ業務コードを追加した、最終的な構成は次の通りです。
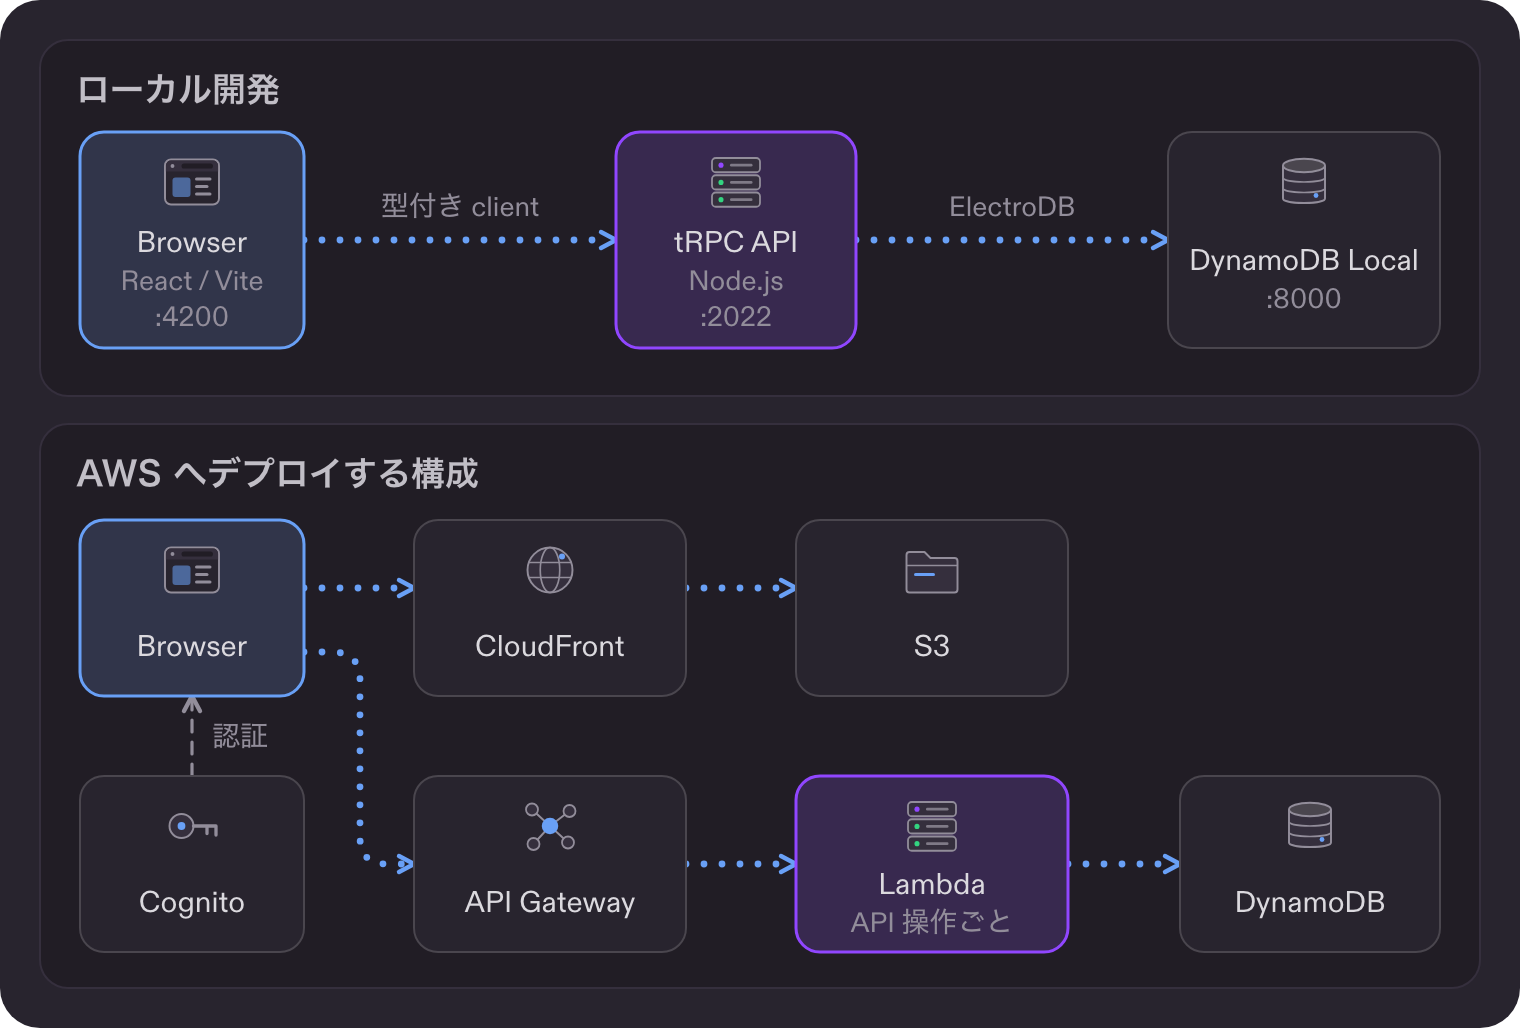
図2: ローカル開発と AWS へデプロイする構成
ローカルでは API とデータベースを手元で起動します。認証は Cognito のローカルエミュレーターが作られるわけではなく、Runtime Config がないローカル開発時はログインを省略する実装です。すべての AWS サービスがローカルで再現されるわけではありません。
ここからは、Generator が用意した部分と、検証のために追加した業務実装を分けながら見ていきます。
Nx Plugin for AWS が狙っているのは、最小コードで最短デモを作ることではありません。複数のアプリケーションを同じ作法で育て始めるための、作り込まれた出発点です。
Nx Plugin for AWS と Nx は何を担当するのか
最も分かりにくかったのが、Nx Plugin for AWS と Nx 本体の境界でした。
一文で分けるなら、AWS 固有の「何を生成するか」を持つのが Nx Plugin for AWS、生成後の Project を「どう管理・実行するか」を担うのが Nx となります。
実際の流れを、担当と実行順が分かるシーケンス図にしました。

図3: Nx Plugin for AWS、Nx、Coding Agent の役割分担
| 担当 | この仕組みで行うこと | 行わないこと |
|---|---|---|
| Coding Agent または開発者 | 要件判断、Nx コマンドの実行、業務コードと ApplicationStack の実装・レビュー |
Generator のテンプレートそのものを提供する |
| Nx Plugin for AWS MCP | Generator の一覧、Schema、推奨手順、注意点を Coding Agent へ返す | Generator を自律的に実行する |
| Nx Plugin for AWS Generator | Website、API、Data、認証、CDK Construct、接続設定などを生成する | 業務要件から最終アーキテクチャを決定する |
| Nx | Generator の実行基盤、Project Graph、Task Graph、target の実行順を提供する | AWS 固有の Website や CDK Construct を単独で生成する |
| AWS CDK | Construct から CloudFormation Template を合成する | Nx Project の依存関係を管理する |
公式ブログの「AI-powered scaffolding」で開発作業を行う AI は Coding Agent です。MCP の説明を読み、Nx CLI を実行し、Generator だけでは完成しない業務コードや CDK Stack の配線を追加します。
Workspace には @aws/nx-plugin-mcp の設定が用意されます。この MCP サーバーが公開するのは、確認した時点で次の 7 種類のガイダンスツールでした。
- 既存プロジェクトへの追加方法
- ベストプラクティス
- Workspace 作成コマンド
- 一般ガイダンス
- Generator の使い方
- Generator 一覧
- Workspace のアップグレード方法
MCP ツール自体が「Website を生成する」「API を生成する」という実行 API ではない点が大事です。Coding Agent は MCP から利用できる Generator、引数、順序、注意点を受け取り、最終的には Nx CLI を実行します。
また、Generator 一覧にある ts#agent や py#agent の Agent は、リポジトリを編集する Coding Agent ではありません。これは Nx Plugin for AWS が生成対象にできる、Bedrock AgentCore などで動かす AI Agent アプリケーションです。
生成前の構成を可視化する Graph Builder
公式サイトには、構成をドラッグ&ドロップで設計できる Graph Builder もあります。
今回の構成に近い tRPC web app プリセットを選ぶと、Website、tRPC API、DynamoDB の接続が次のように表示されました。

図4: 公式 Graph Builder の tRPC web app プリセット
Graph Builder で描いた各コンポーネントは Nx Plugin for AWS の Generator に、線は connection Generator に対応します。構成を変更すると、Workspace、各 Project、接続、infra Project を生成するコマンドが依存順に更新されます。
ただし、これは既存 Workspace を解析する Nx の画面ではありません。3 種類のグラフは目的が異なります。
| 画面 | タイミング | 担当 | 分かること |
|---|---|---|---|
| Graph Builder | 生成前 | Nx Plugin for AWS | 何を生成し、どの Project を接続するか |
| Project Graph | 生成後 | Nx | Project 間のコード依存関係 |
| Task Graph | コマンド実行時 | Nx |
build、synth などの target をどの順番で実行するか |
Workspace を作る
今回は再現しやすいよう、Coding Agent へ任せる代わりに同じ Generator を CLI から実行しました。
pnpm create @aws/nx-workspace research-board \
  --interactive=false \
  --pm=pnpm \
  --nxCloud=skip \
  --skipGit \
  --aiAgents=codex
作成直後の Workspace には、アプリ本体がまだありません。それでも次のものが用意されています。
- Nx、TypeScript、Biome、Vitest の共通設定
- CDK と Container Engine の設定
- Husky と git-secrets
- Coding Agent 向け MCP 設定
- Coding Agent が参照する Skills
- 共通スクリプト
-
dev、build、lint、test、affectedなどの入口
たとえば .mcp.json には Nx Plugin for AWS の MCP サーバーが登録されます。
{
  "mcpServers": {
    "nx-plugin-for-aws": {
      "command": "npx",
      "args": ["-y", "@aws/nx-plugin-mcp"]
    }
  }
}
Generator は Website と API だけではない
インストールされた generators.json を確認すると、内部用も含めて 73 個の ID があり、通常利用者から見える Generator は 29 個でした。
大きく分けると次のカテゴリがあります。
- TypeScript Website、API、Lambda、MCP Server
- TypeScript / Python の AI Agent アプリケーション
- DynamoDB、RDB
- CDK、Terraform
- Smithy
- 認証
- Project 間の connection
- ライセンスや Workspace 初期化
フロントエンドだけの Plugin ではなく、Website、API、AI Agent アプリケーション、Data、IaC が同じ Workspace に増えていく前提です。Nx を採用する理由もここにあります。
Generator を組み合わせる
今回の構成は、次の順番で作りました。
Website
  └─ Cognito 認証を追加

API
  └─ DynamoDB Data Project を追加

Website ─ connection ─> API
API     ─ connection ─> Data

最後に CDK App
実際には Generator ごとに dry-run で変更内容を確認してから適用しています。
# React Website
pnpm nx g @aws/nx-plugin:ts#website feedback-web

# Cognito 認証
pnpm nx g @aws/nx-plugin:ts#website#auth \
  --project=@research-board/feedback-web

# tRPC API
pnpm nx g @aws/nx-plugin:ts#api feedback-api \
  --framework=trpc

# DynamoDB Data Project
pnpm nx g @aws/nx-plugin:ts#dynamodb feedback-data

# Website から API への接続
pnpm nx g @aws/nx-plugin:connection \
  --sourceProject=@research-board/feedback-web \
  --targetProject=@research-board/feedback-api

# API から Data への接続
pnpm nx g @aws/nx-plugin:connection \
  --sourceProject=@research-board/feedback-api \
  --targetProject=@research-board/feedback-data

# CDK App
pnpm nx g @aws/nx-plugin:ts#infra infra
最終的な Nx Project は 7 個です。
packages/
├── common/
│   ├── constructs/
│   ├── scripts/
│   └── shadcn/
├── feedback-api/
├── feedback-data/
├── feedback-web/
└── infra/
$ pnpm nx show projects

@research-board/common-constructs
@research-board/common-scripts
@research-board/common-shadcn
@research-board/feedback-api
@research-board/feedback-data
@research-board/feedback-web
@research-board/infra
ここからが今回最も知りたかった部分です。それぞれの Generator は、具体的に何を作ったのでしょうか。
Website Generator が作るもの
Website Generator は、空の React プロジェクトだけを作るわけではありません。
- React 19
- Vite
- TanStack Router
- TanStack Query
- Tailwind CSS
- shadcn/ui
- Vitest
- ローカル開発用 Runtime Config
- S3 + CloudFront 用 CDK Construct
- WAF、ログ、暗号化を含む共通 Construct
初期画面にはサイドバー、ヘッダー、ユーザーメニューがあり、業務アプリの外枠まで作られます。中身は Welcome 画面なので、ここから機能を実装します。
認証 Generator を追加すると、React 側には Cognito の設定を読み込む Provider とログイン処理が入り、CDK 側には UserIdentity Construct が追加されました。
この Construct の初期値はかなり安全寄りです。
- MFA 必須
- 厳格なパスワードポリシー
- Cognito threat protection
- WAF
- User Pool の削除保護
- ログの暗号化
本番の出発点としては助かる設定ですが、検証環境へそのままデプロイすると、想定より構成と料金が大きくなる可能性があります。生成されたから採用するのではなく、要件に合わせて初期値をレビューすべきです。
API Generator が作るもの
tRPC を選ぶと、次のものが作られます。
- Zod Schema
- tRPC Router と Procedure
- Lambda Handler
- ローカル HTTP Server
- API Gateway 用 CDK Construct
- AWS Lambda Powertools の Logger、Metrics、Tracer
- AWS AppConfig 経由の Runtime Config
- CORS 制御
-
AWS_IAM認証 - WAF
初期実装は echo Procedure だけです。
export const appRouter = router({
  echo,
});
一見単純ですが、CDK 側の defaultIntegrations() は Router を解析し、Procedure ごとに独立した Lambda Integrationを作れるようになっています。
今回 createFeedback、listFeedback、updateFeedbackStatus の 3 Procedure に置き換えると、業務 API 用 Lambda も 3 個になりました。
これは便利ですが、Procedure を増やせば Lambda と API Gateway Method も増えます。1 Router を 1 Lambda で動かしたいシステムでは shared pattern を選ぶなど、生成された構成の粒度を確認する必要があります。
DynamoDB Generator が作るもの
DynamoDB Generator が作るのは、テーブルの CDK コードだけではありません。ローカル開発の仕組みまで含まれます。
- ElectroDB の Entity サンプル
- テーブル名を解決する Runtime Config
- DynamoDB Local の設定
- Finch / Docker でコンテナを起動する target
- Primary Key と GSI の設定ファイル
- DynamoDB Table 用 CDK Construct
- 読み書き権限を付与する helper
生成されたサンプル Entity は ExampleEntity です。今回はこれを FeedbackEntity に置き換えました。
export const FeedbackEntity = new Entity({
  model: {
    entity: 'feedback',
    version: '1',
    service: 'FeedbackBoard',
  },
  attributes: {
    id: { type: 'string', required: true },
    title: { type: 'string', required: true },
    description: { type: 'string', required: true },
    category: {
      type: ['bug', 'feature', 'question'] as const,
      required: true,
    },
    priority: { type: 'number', required: true },
    status: {
      type: ['new', 'in-progress', 'resolved'] as const,
      required: true,
      default: 'new',
    },
    createdAt: { type: 'string', required: true },
  },
  indexes: {
    primary: {
      pk: { field: 'pk', composite: ['id'] },
      sk: { field: 'sk', composite: [] },
    },
    byStatus: {
      index: 'gsi1pk-gsi1sk-index',
      pk: { field: 'gsi1pk', composite: ['status'] },
      sk: { field: 'gsi1sk', composite: ['createdAt'] },
    },
  },
});
CDK Construct の初期値も安全寄りです。
- On-demand billing
- Point-in-time recovery
- 削除保護
RETAIN- Customer managed KMS Key
- Key rotation
これも本番向けには有用ですが、短期間の検証環境では削除保護や RETAIN が後片付けを難しくします。
connection は何を接続するのか
connection という名前から、API の CRUD 実装や IAM 権限まで自動で完成するように見えるかもしれません。
実際には、接続元と接続先の組み合わせごとに役割が異なります。ソースを確認したところ、対応する connection の組み合わせは 35 種類ありました。
今回試した 2 つでも挙動は違います。
Website → API
Website から tRPC API への connection は、かなり多くのコードを追加しました。
FeedbackApiClientProvider- TanStack Query Provider
- API Client を取得する Hook
- Router の型参照
-
main.tsxへの Provider 組み込み - ローカル API URL
- Website の
devから API のdevへの依存
これにより、フロントエンドでは API Router の型を利用できます。
const api = useFeedbackApiClient();

const feedback = useQuery(api.listFeedback.queryOptions());
API → Data
一方、API から Data への connection は、API の dev target が Data の dev target に依存するよう設定するのが中心でした。
Data Project の Entity を API に import し、CRUD Procedure を書くところまでは行いません。
この差は重要です。
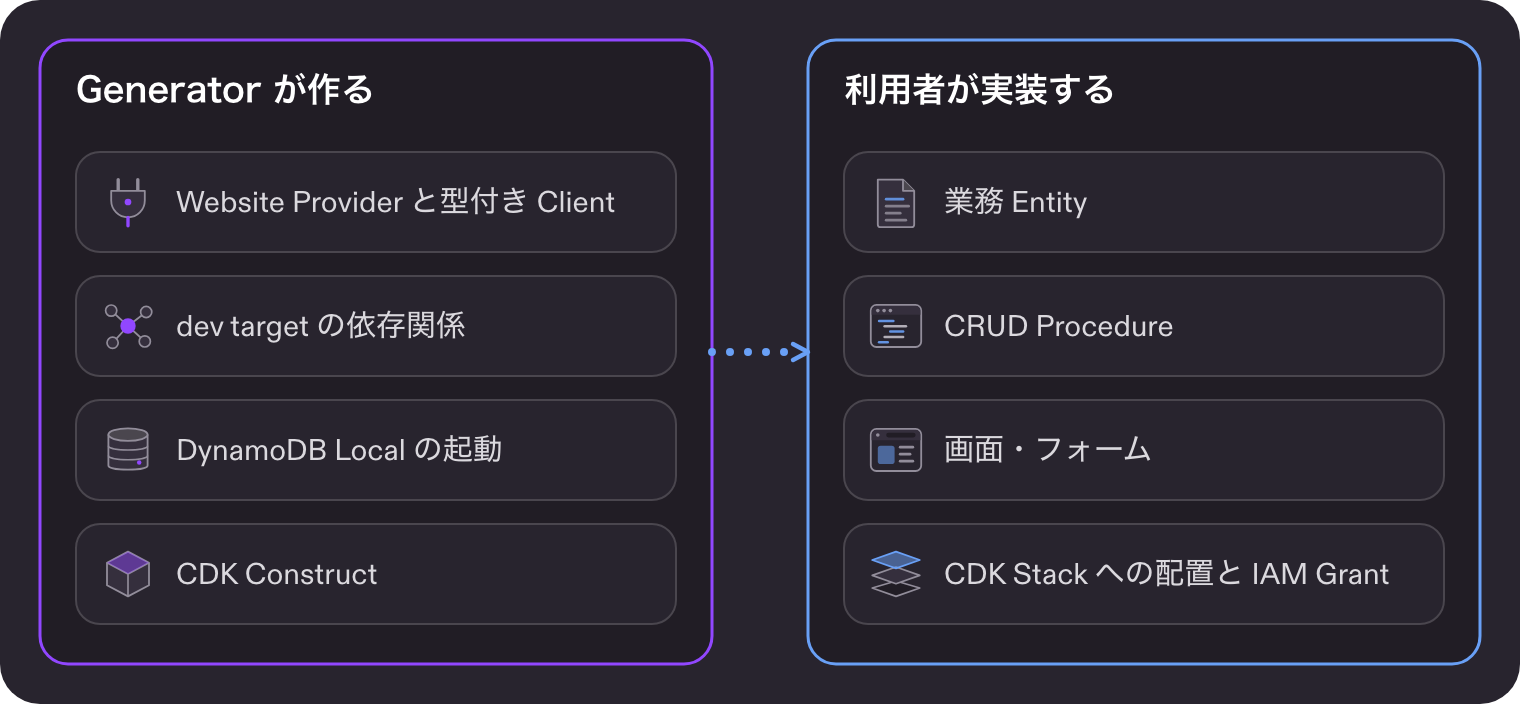
図5: Generator が作る部分と利用者が実装する部分
Generator は「接続できる状態」までを作ります。業務上のデータモデルや認可境界まで推測して完成させるものではありません。
Feedback Triage Board を実装する
Generator 実行直後は、Welcome、Echo、ExampleEntity の状態です。そこへ次の 3 Procedure を実装しました。
export const appRouter = router({
  listFeedback,
  createFeedback,
  updateFeedbackStatus,
});
Procedure では feedback-data の Entity を利用します。
export const createFeedback = publicProcedure
  .input(CreateFeedbackInputSchema)
  .mutation(async ({ input }): Promise<FeedbackRecord> => {
    const entity = await createFeedbackEntity();
    const result = await entity
      .create({
        id: randomUUID(),
        ...input,
      })
      .go();

    return FeedbackRecordSchema.parse(result.data);
  });
API の公開型が ElectroDB の内部型へ依存しないよう、戻り値は Zod Schema で検証し、明示した FeedbackRecord として返します。
この import を追加した後に nx sync を実行すると、Nx Plugin for AWS が次を自動更新しました。
- API の
package.jsonに@research-board/feedback-data: workspace:* - API の TypeScript Project Reference に
feedback-data
pnpm nx sync
ここは Nx らしい部分です。ソースコード上で新しい依存関係が生まれると、Workspace の Package と TypeScript の参照関係も同期されます。
フロントエンドでは、生成された Provider を利用して登録・一覧・更新画面を実装しました。
図6: 登録・一覧・ステータス更新を実装した画面
登録・一覧・ステータス更新は React の State だけで完結せず、tRPC API を経由して DynamoDB Local へ保存されます。
nx dev ひとつで 3 Project を起動する
Website だけを指定して dev を実行します。
pnpm nx dev @research-board/feedback-web --outputStyle=stream
Nx は Project 間の依存関係をたどり、次の順序で起動しました。
- DynamoDB Local
- tRPC API
- React / Vite
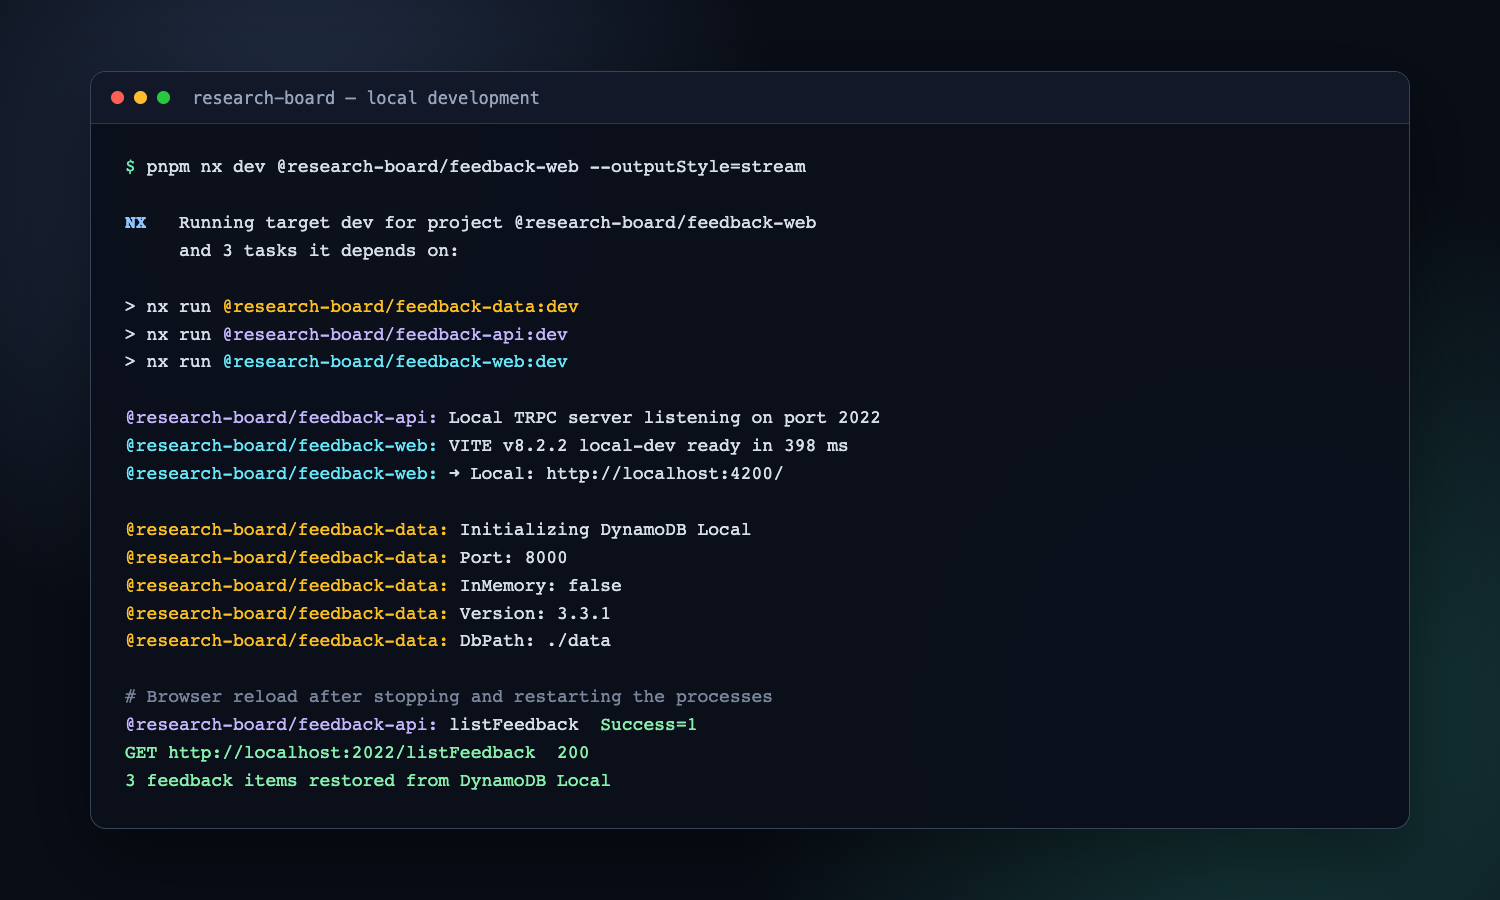
図7: nx dev で DynamoDB Local、tRPC API、Vite が起動する
この体験は単なる concurrently でも作れます。ただし Nx では、起動順が個別のシェルスクリプトではなく、Project と target の依存関係として管理されます。
API や Data が増えたときも、Website の開発者は依存先の起動コマンドを覚える必要がありません。
一方、target の依存関係が保証するのは起動順であり、各サービスの準備完了ではありません。安定したローカル起動には、health check や retry を別途組み込む必要があります。
Nx の Web UI で生成後の関係を確認する
Graph Builder が「生成前に何を作るか」を設計する画面なのに対し、nx graph は生成後の Workspace を解析する画面です。
Project Graph
実装後の Project Graph がこちらです。
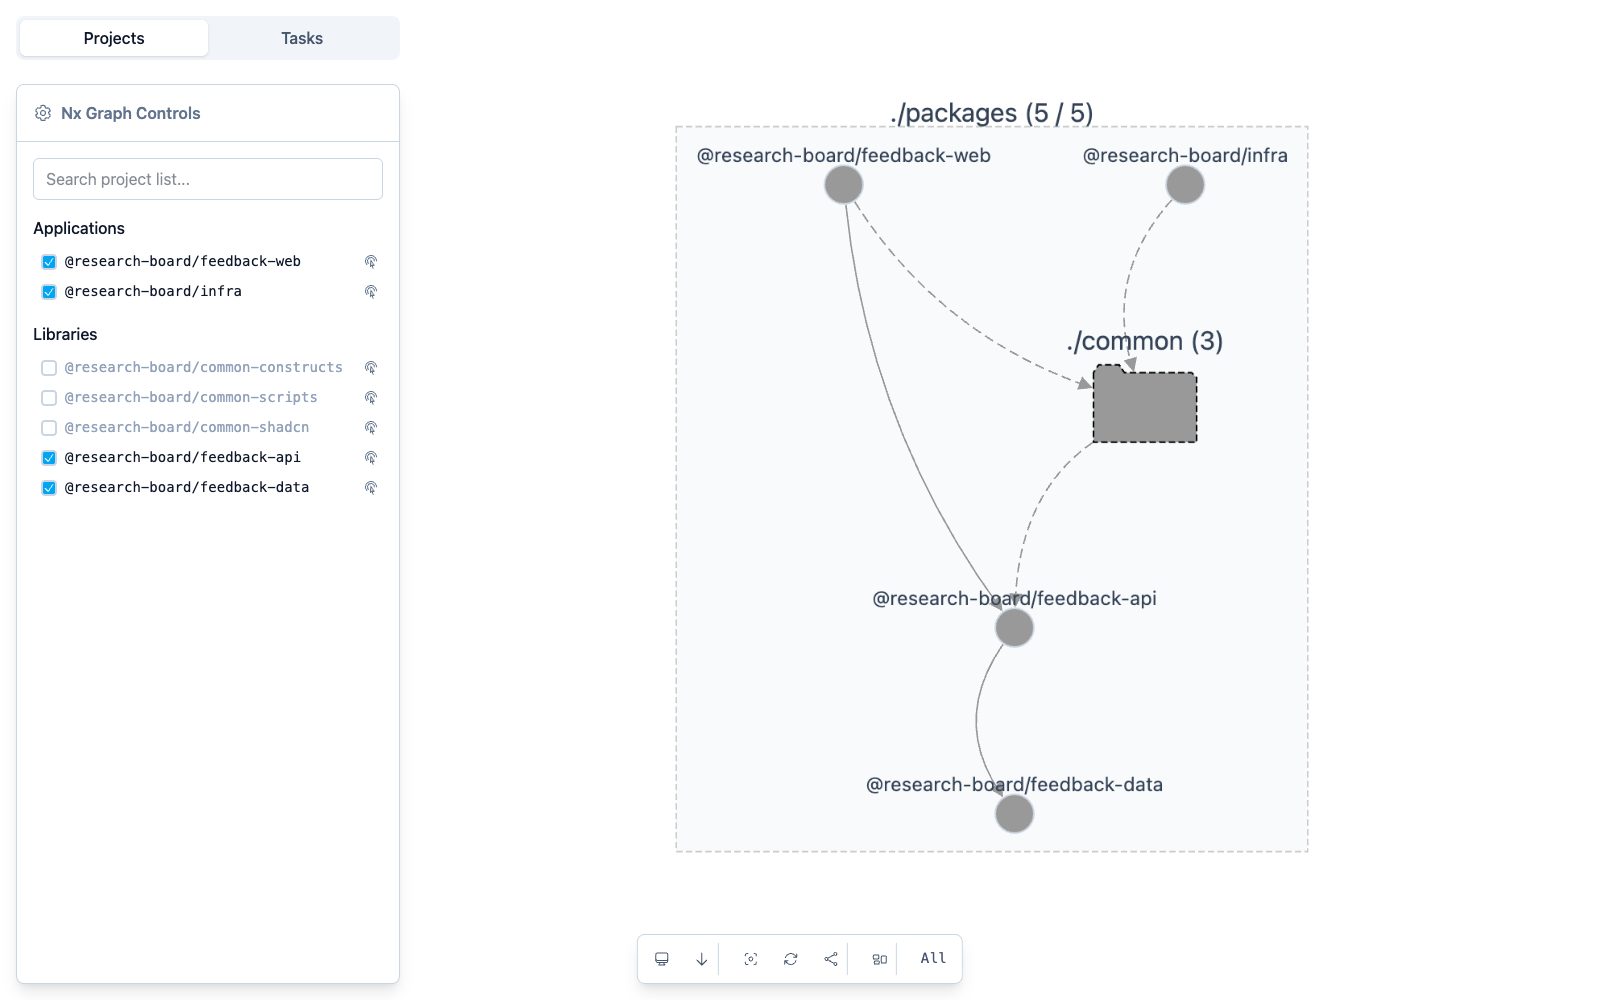
図8: 実装後の Project Graph
主要な依存関係は次のようになりました。
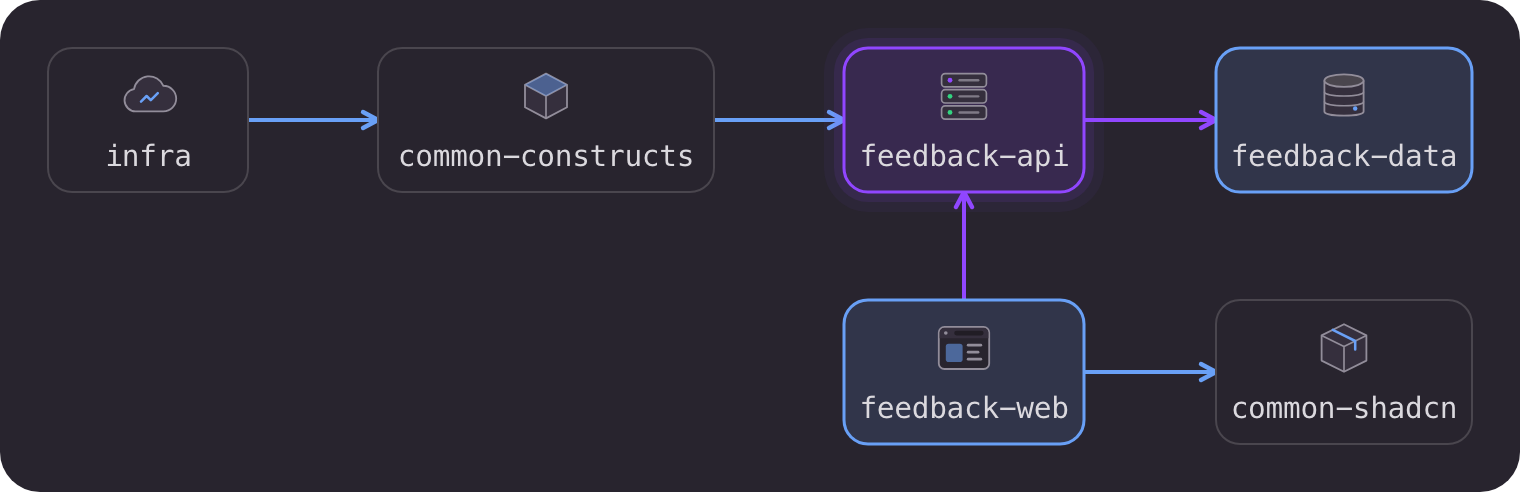
図9: 主要な Project 間の依存関係
実線の Web → API と API → Data は、実際の TypeScript import から検出された依存関係です。
Project Details
Project を選択すると、右側に Root、利用できる target、直接の依存先と依存元が表示されます。
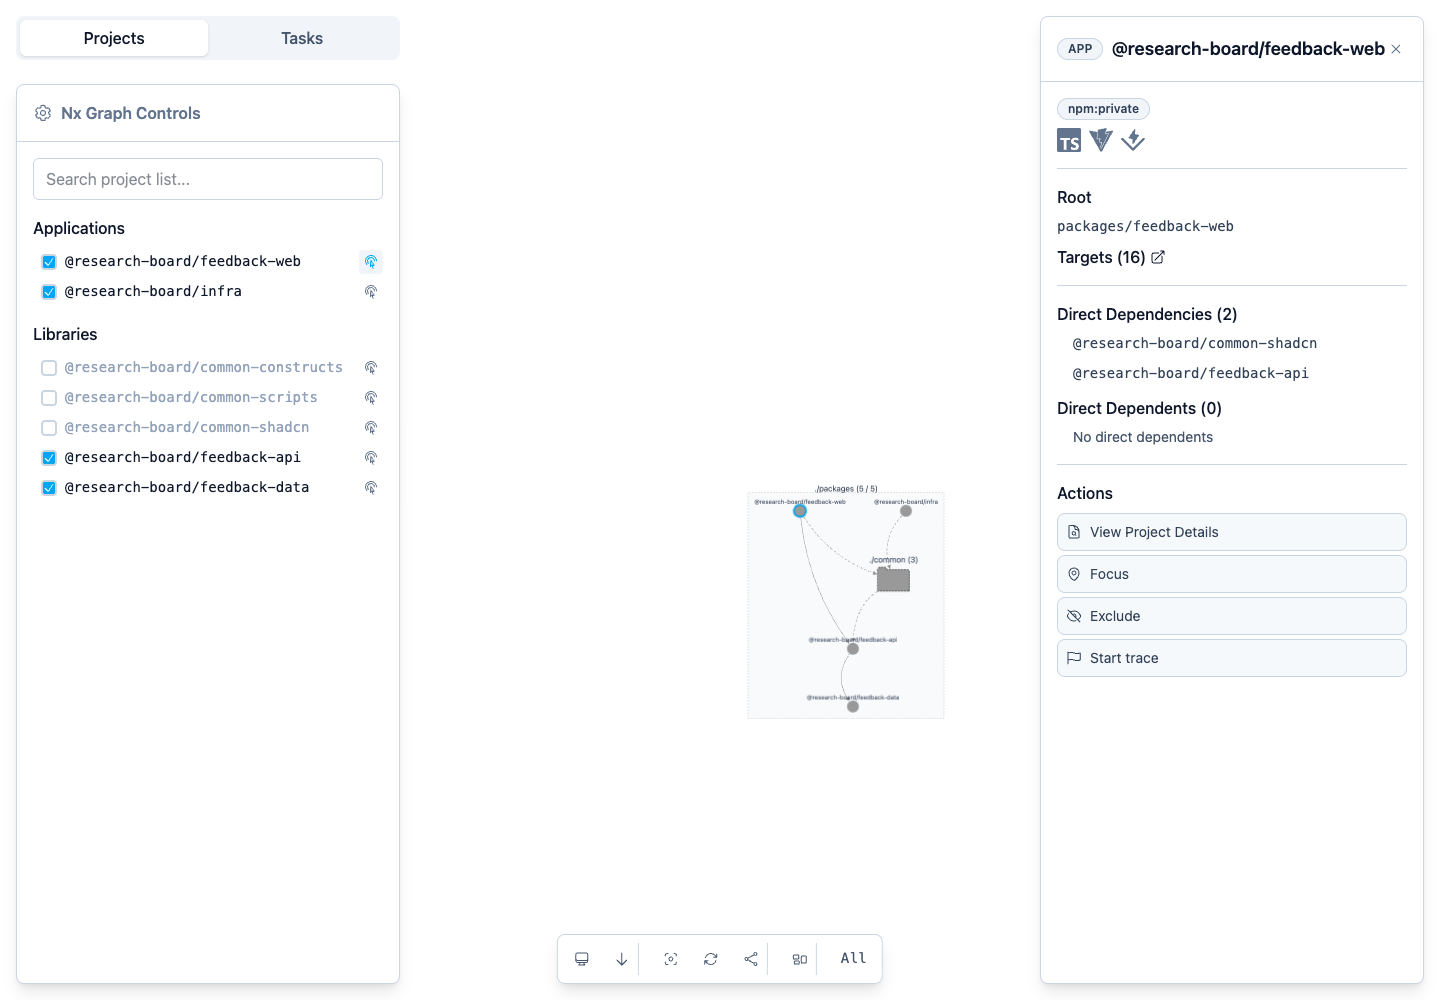
図10: feedback-web の Project Details
今回の feedback-web には 16 個の target があり、直接の依存先は common-shadcn と feedback-api でした。画面から特定 Project だけへ Focus したり、依存経路の Trace を開始したりできます。
Task Graph
Project Graph がコード上の関係を表すのに対し、Task Graph はコマンドを実行するときの順序を表します。
次は infra:synth だけを選択した Task Graph です。

図11: infra synth の前に実行される task の Task Graph
infra:synth から、common-constructs:assemble、Website と API の bundle、各 Project の compile まで依存関係をたどれます。つまり「CDK synth の前に何が必要か」をシェルスクリプトではなく、Nx の Task Graph として確認できます。
ここまで来て、ようやく「なぜ Nx か」に答えられるようになりました。
このアプリが 1 Website、1 API、1 Table のままなら、Nx がなくても管理できます。しかし次のように増えたらどうでしょうか。
- 管理画面と利用者画面
- 複数の API
- 共有 UI
- 複数の Data Project
- Python Lambda
- Bedrock AgentCore Agent
- MCP Server
- CDK と Terraform
単に同じリポジトリへ置くだけでは、「何が何に依存しているか」「どの target を先に動かすか」が各種設定ファイルへ分散します。
Nx Plugin for AWS は AWS 用の Project と target を同じ規約で生成し、Nx は生成後のコードと設定を読み取って Project Graph と Task Graph を構築します。Generator の数ではなく、生成後に Project が増えても関係と実行順を保てることが Nx を使う理由です。
CDK は誰が書くのか
CDK の infra Project を生成した直後、ApplicationStack は空でした。
ここも実行主体を分けると分かりやすくなります。
| 作業 | 実行主体 |
|---|---|
FeedbackWeb、FeedbackApi、FeedbackData など再利用可能な CDK Construct を生成 |
Nx Plugin for AWS Generator |
ts#infra Generator を起動 |
開発者または Coding Agent が Nx CLI を実行 |
ApplicationStack で Construct を選び、IAM Grant や CORS を配線 |
開発者または Coding Agent |
infra:synth より前に必要な bundle、assemble、compile を実行 |
Nx Task Runner |
| CDK App から CloudFormation Template を生成 | AWS CDK |
つまり、CDK をすべて Generator が完成させるわけでも、Coding Agent がゼロからすべて書くわけでもありません。
Generator は FeedbackWeb、FeedbackApi、FeedbackData、UserIdentity といった Construct を作ります。一方、どの Construct を採用し、どう権限をつなぐかは設計判断です。公式ブログのように Coding Agent へ一連の構築を依頼した場合は、Coding Agent が ApplicationStack を編集します。CLI を手動実行する場合は、開発者が同じ箇所を実装します。
今回は次のように配置しました。
import {
  FeedbackApi,
  FeedbackData,
  FeedbackWeb,
  UserIdentity,
} from '@research-board/common-constructs';
import { Stack, StackProps } from 'aws-cdk-lib';
import { Construct } from 'constructs';

export class ApplicationStack extends Stack {
  constructor(scope: Construct, id: string, props?: StackProps) {
    super(scope, id, props);

    const identity = new UserIdentity(this, 'Identity');
    const data = new FeedbackData(this, 'Data');
    const integrations = FeedbackApi.defaultIntegrations(this).build();

    data.grantWriteData(integrations.createFeedback.handler);
    data.grantReadData(integrations.listFeedback.handler);
    data.grantWriteData(integrations.updateFeedbackStatus.handler);

    const api = new FeedbackApi(this, 'Api', {
      integrations,
    });
    api.grantInvokeAccess(identity.identityPool.authenticatedRole);

    const web = new FeedbackWeb(this, 'Web');
    api.restrictCorsTo(web);
  }
}
ここで人が判断しているのは、たとえば次の点です。
-
UserIdentityConstruct を配置するか - API を operation ごとの Lambda にするか
- どの Lambda に DynamoDB の権限を与えるか
- Identity Pool の authenticated role に API の実行権限を与えるか
- Website からの CORS だけを許可するか
- 生成された WAF や KMS の初期値を使うか
この配線は Coding Agent に任せることもできます。ただし、Generator が保証する定型部分ではなく、IAM や公開範囲に関わる設計判断なので、人によるレビューが必要です。
CDK synth と Checkov まで試す
infra:synth を実行すると、Nx は依存する API と Website の bundle を先に作り、その後 CDK synth を実行しました。
pnpm nx run @research-board/infra:synth
メインの CloudFormation Template は 97 リソースです。CloudFront WAF 用の別 Stack にも 5 リソースありました。
主なリソースは次の通りです。
- API Gateway REST API
- 業務 API 用 Lambda 3 個
- CDK Custom Resource 用 Lambda
- DynamoDB
- Cognito User Pool / Identity Pool
- CloudFront
- S3
- WAF
- KMS Key
- CloudWatch Logs
- AWS AppConfig
- IAM Role / Policy
続けて Checkov を実行しました。
pnpm nx run @research-board/infra:checkov
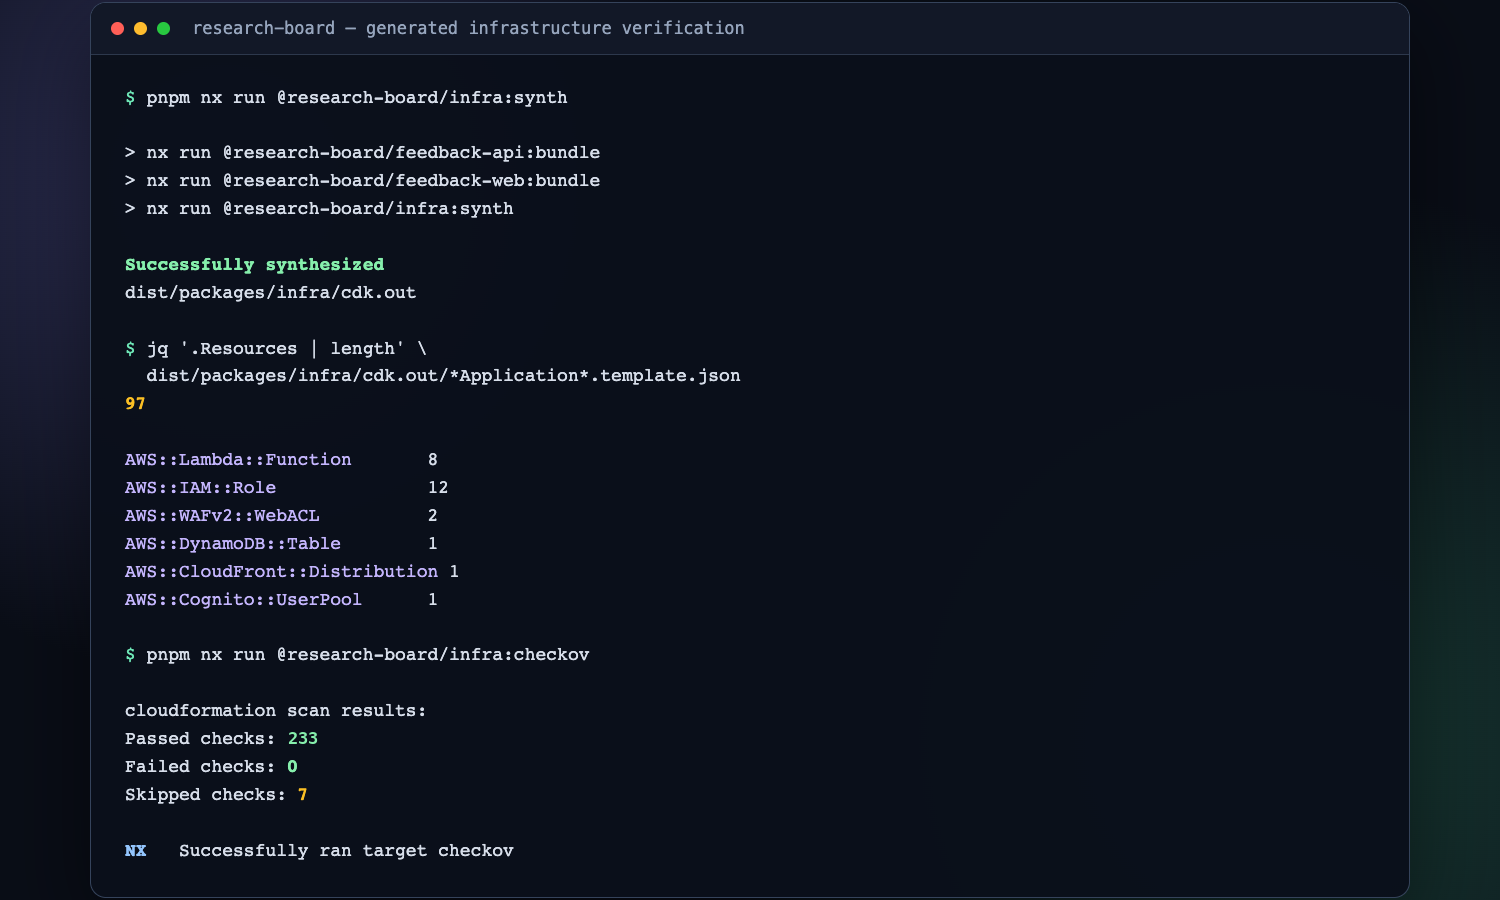
図12: Checkov は 0 failed だが 7 件は skip されている
結果は 233 passed、0 failed、7 skipped でした。0 failed でも 7 項目は明示的に skip されているため、全項目を通過したという意味ではありません。
同じ構成を AWS へデプロイすると、Application Stack の 97 リソースと CloudFront WAF Stack の 5 リソースが作成されました。CloudFormation のイベント時刻では、2 Stack の作成開始から完了まで約 5 分 25 秒でした。
「React と API を数分で生成」という説明だけだと軽いスターターに見えますが、実際にはログ、暗号化、WAF、Runtime Config、セキュリティ検証まで含む、かなり作り込まれた構成です。
これはメリットである一方、次の点に注意が必要です。
- Cognito の Plus feature plan
- 複数の WAF
- 複数の KMS Key
- operation ごとの Lambda
- ログ保存
- 削除保護と
RETAIN
小さな検証環境でも、生成された構成を理解せずにデプロイすべきではありません。
また、生成される deploy-sandbox target は cdk deploy --express を使います。Express mode はリソースの安定化を待たずに成功を返し、失敗時の自動 rollback も標準では有効にならない開発向けのモードです。本番デプロイへそのまま流用すべきではありません。
AWS Blocks / Amplify との位置付け
混同しやすいので、違いだけ簡潔に整理します。
| 主に担当すること | 特徴 | |
|---|---|---|
| Nx Plugin for AWS | モノレポ全体の生成・接続・実行管理 | React、API、Data、CDK などのコードを生成し、Nx のグラフで管理する |
| AWS Blocks | アプリから使うクラウド機能 | Block がローカル実装と AWS 上の実装を抽象化する |
| Amplify Gen 2 | Frontend と Backend の開発・デプロイ | TypeScript の Backend 定義、開発者 Sandbox、Hosting を一体化する |
Nx Plugin for AWS の生成物は、通常の React、tRPC、ElectroDB、CDK です。Nx Plugin は開発・生成ツールとして使われ、デプロイ後のアプリを実行時に抽象化するものではありません。
AWS Blocks は KVStore や DistributedTable のような Block をアプリコードから利用します。Amplify Gen 2 は defineAuth や defineData で Backend を定義し、Sandbox や Hosting まで含めて扱うツールです。
Nx Plugin for AWS はさらに外側から、複数 Project が同居する Repository をどう構成し、どう一貫して動かすかを担当します。
実際に試して分かった注意点
Generator を実行しただけではアプリは完成しない
生成直後にあるのは Welcome、Echo、ExampleEntity です。
業務 Entity、CRUD、画面、認可、IAM Grant、CDK Stack への配置は実装が必要です。Coding Agent に依頼すれば続きも書けますが、それは Generator の保証範囲ではありません。
connection の仕事は組み合わせごとに違う
Website → API は型付き Client と Provider まで追加しましたが、API → Data はローカル起動の依存設定が中心でした。
「接続」という名前だけで期待せず、dry-run と差分を確認した方がよいです。
nx sync を実行する
Project 間の import を追加した後、Package dependency と TypeScript Project Reference を同期するために nx sync を実行します。
pnpm nx sync
Generator 実行後や Project 間の依存追加後に、まず確認したいコマンドです。
生成される AWS 構成は小さくない
今回の小さなアプリでも、メインテンプレートは 97 リソースでした。
WAF、KMS、Cognito の feature plan、削除保護、ログ、Lambda の分割方式は、セキュリティと料金の両方に関係します。生成コードの初期値を組織の標準と照らし合わせる必要があります。
ローカルですべてを再現するわけではない
DynamoDB と tRPC API はローカルで動きましたが、Cognito はローカルエミュレーションではありません。
ローカルと AWS で動作が異なる箇所を把握し、認証を含む結合確認は別途 AWS 環境で行う必要があります。
生成コードも保守対象になる
独自の閉じた形式ではなく通常の React、TypeScript、CDK が残るのは利点です。一方で、それらのコードは自分たちの保守対象です。
Plugin の Migration はありますが、大きく変更した生成コードへ常に自動適用できるとは限りません。生成時点だけでなく、更新方針も決めておく必要があります。
まとめ
Nx Plugin for AWS を実際の CRUD アプリまで作って試すと、公式ブログだけでは見えにくかった役割分担が分かりました。
Graph Builder は生成前の構成を Generator コマンドへ変換し、MCP は Coding Agent に Generator の使い方と順序を教えます。Nx Plugin for AWS の Generator は React、API、Data、認証、IaC の作り込まれた出発点を用意し、connection は型付き Client やローカル起動の依存関係を追加します。業務モデル、CRUD、IAM、CDK Stack の最終配線は、開発者または Coding Agent が実装する部分でした。生成後の関係と実行順は、Nx が Project Graph、Project Details、Task Graph で管理します。AWS Blocks はクラウド機能の実行モデルを抽象化する別レイヤー、Amplify Gen 2 は Backend、Sandbox、Hosting を一体化する Platform という位置付けです。
最初は「AI scaffolding なら Nx でなくてもよいのでは」と思っていました。
1 個のアプリを一度生成するだけなら、その疑問は今も正しいと思います。Nx の価値は生成の瞬間ではなく、Website、API、Data、AI Agent アプリケーション、IaC が増えた後も、Repository 全体をグラフとして扱い続けられることにあります。
今回の検証で、Nx Plugin for AWS は、Coding Agent と開発者が同じ設計規約で AWS アプリを開発するための、実務を意識した共通基盤だと理解できました。

この Publication に投稿している記事は、アマゾン ウェブ サービス ジャパン合同会社または Amazon Web Services, Inc. 所属社員による個人の見解であり、所属する組織の公式見解ではありません。参加したい従業員の方は、Hikoto Iseda までお知らせください。
Discussion