


はじめに
こんにちは、AWS Japan でソリューションアーキテクトをしているいなりくです。
AI エージェントを業務に入れようとすると、必ず同じ壁にぶつかります。データはあるのに、業務の意味が渡っていないという壁です。
- 「売上」は
total_amountの合計なのか、送料込みなのか、キャンセル分を引くのか - 「この注文はキャンセルできる?」に答えるには、注文テーブルの状態とキャンセルポリシー文書の両方が必要
- 「アクティブ顧客」の定義は部署ごとに違うかもしれない
これらは人間の頭と社内ドキュメントの中にあり、information_schema には存在しません。LLM がいくら賢くなっても、書かれていないものは読めません。
この影響は、ベンチマークにはっきり表れています。数十テーブル規模の学術ベンチマーク Spider 1.0 では 9 割超の正解率が出る Text-to-SQL が、実企業のデータベース(1,000 カラム超が珍しくない)を集めた Spider 2.0 では 2 割前後まで落ちることが報告されています(論文では o1-preview ベースのコードエージェントが Spider 1.0 の 91.2% に対し 21.3%)。エラーの主因は述語の指定ミスとスキーマのグラウンディング、つまり「言葉と列の結びつけ」の失敗です。モデルの賢さではなく、渡している情報の側に原因があります。
この「業務の意味」を機械が読める形で書き、推論や検証までできるようにしたものがオントロジーです。そして本記事で解説する Context Ontology Accelerator(以下 COA)は、オントロジーとナレッジグラフを自動生成し、AI エージェントに提供するための AWS の OSS です。
構成は次の通りで、オントロジーを触ったことがない方でも読めるよう概念の説明から始めます。
- AI に業務知識を渡すことが、なぜ 2026 年の主戦場なのか
- オントロジーとは何か(何のためにあるのか、未経験者向けの入門)
- COA の仕組み(Scan → Model → Serve のアーキテクチャ)
- 機能を画面で見る(スクリーンショットで各機能を解説)
- 実際に動かして分かったこと(実測値と精度検証、限界)
- どんな人が救われるのか(ユースケース別)
- 他の選択肢との違い
なお筆者は実際に AWS アカウントへデプロイし、日本語のサンプルデータで一周させています。解説の裏付けとして実測値を随所に挟みますので、導入検討の判断材料にしてください。
1. AI に業務知識を渡すことが、なぜ 2026 年の主戦場なのか
エージェントの実用化が進むにつれ、精度を決めるのはモデルよりも渡すコンテキストだという認識が広がりました。構造化データと非構造化データの両方で、同じ結論が出ています。
構造化データ側は前述の Text-to-SQL です。その後の研究でも Spider 2.0 系の実行正解率は数割の水準にとどまり、より新しい派生ベンチマークでも 67〜70% 台です。
非構造化データ側も同様で、ナレッジグラフを使う検索(GraphRAG)がベクトル検索単独より有利になるのは、複数の文書やエンティティを跨ぐ質問(マルチホップ)でした(AWS や各社の検証)。単語の類似度では拾えない「関係を辿る」問いに、構造を持った知識表現が効くという話です。
こうした背景から、2026 年前半のデータ業界は、AI に渡す意味の層を整備することに一斉に動いています。Snowflake は業務メトリクスやエンティティ間の関係をデータベース内のオブジェクトとして定義する Semantic Views、Databricks は Unity Catalog の Metric Views(測定値の定義と集計軸を分離し、一度定義した指標を実行時に問い合わせる仕組み)、Microsoft は Fabric IQ の Ontology(業務エンティティと関係を定義してデータに結びつける層)を、それぞれ提供しています。名称は「セマンティックレイヤー」「オントロジー」と揺れていますが、どれも狙いは同じで、業務の意味を機械可読な資産にすることです。
効果も数字で示されています。dbt の 2026 年ベンチマークでは、セマンティックレイヤーがカバーする範囲の質問について正解率がほぼ 100% に達すると報告されています(dbt Labs のブログ)。クエリ生成が決定的(deterministic)になるため、LLM が「微妙に間違った結果」を作れなくなる、という説明です。
つまり業界の答えは「モデルをさらに賢くする」ではなく、「渡す情報に意味を持たせる」でした。COA も同じ問題意識に立ちますが、後述するようにメトリクス定義より表現力の高いアプローチを取ります。
2. オントロジーとは何か
「オントロジー」は哲学由来の言葉ですが、ここでの意味はずっと具体的です。業務の語彙・関係・ルールを、機械が読める形で書いたものです。
架空の EC サイト「みどり商店」を例に、オントロジーが表現する知識を挙げてみます。
- クラス(概念): 顧客、注文、商品、決済、出荷
- 関係(プロパティ): 注文は 1 人の顧客に属する。注文は複数の明細を持つ。出荷は注文に対して行われる
- 属性: 顧客は地域を持つ。注文は合計金額と状態を持つ
- 制約・ルール: キャンセルされた注文に決済レコードは存在しない。食品カテゴリは返品できない
オントロジーは何のためにあるのか
ここで誤解を解いておきたいのですが、オントロジーは SQL を生成するための仕組みではありません。知識表現の枠組みであり、本来の役割は次の 4 つです。いずれも SQL とは独立しています。
1 つめは意味的な相互運用性(データ統合)です。別々に作られたシステムが同じ概念を違う名前・違う粒度で持っているとき、共通の概念体系に写像して繋ぎます。オントロジーの最も古典的な用途です。
2 つめは推論です。明示的に書いていない事実を導き、矛盾を検出します。「A は B の一種」「B と C は排反」なら「A は C ではない」が自動的に導けます。記述論理に基づくからできることで、リレーショナルモデルにはこの能力がありません。
3 つめは制約とデータ品質です。「注文には必ず 1 人の顧客がいる」といったルールを機械可読に書き、データが従っているかを検証します。
4 つめは知識の共有と再利用です。業界標準の概念体系として流通させます。医療の SNOMED CT、生命科学の Gene Ontology、金融の FIBO などが実例で、これらは「SQL を書くため」に作られたものではありません。
Text-to-SQL はオントロジーの応用の一つ
では冒頭の Text-to-SQL はどう位置づくのか。系譜で見ると 3 段階離れた応用です。
オントロジー(知識表現、1990 年代〜)
  └─ OBDA(オントロジー経由でデータに問う枠組み、2000 年代〜)
       └─ SPARQL → SQL 変換(Ontop などの実装)
            └─ 自然言語 → SPARQL / SQL(LLM を載せた最近の応用)
つまり Text-to-SQL は最下層に位置し、しかも近年になって加わった応用にすぎません。オントロジーの側から見れば、数ある使い道の一つです。
COA 自体もそう作られています。後の章で見ていきますが、COA がオントロジーを使う場面は SQL 生成だけではありません。
| COA での用途 | SQL 生成と関係するか |
|---|---|
| HermiT 推論器による論理的整合性の検証 | しない(前述の役割 2) |
| SHACL 制約の生成と検証 | しない(役割 3) |
| FIBO / Schema.org へのグラウンディング | しない(役割 1・4) |
| グラフ探索による文書横断の回答(Tier 3) | しない |
| MCP でエージェントにコンテキスト提供 | 一部 |
| NL→SPARQL / SQL の生成(Tier 2) | する |
COA には is_mapped という仕組みがあり、「SQL が引けるクラス」は全体の一部として明示的に区別されています。残りは知識検索の用途に回ります。オントロジーは SQL のための道具ではない、という前提が設計に現れているわけです。
以降では、その「一部」である Text-to-SQL も含めて全体を見ていきます。
ER 図とどう違うのか
「それは ER 図では?」と思われるかもしれません。違いは 2 点です。
ER 図が表すのはテーブルの形(どの列がどの列を参照するか)です。一方オントロジーが表すのは意味で、物理的なテーブル構成から独立しています。「顧客」という概念が 3 テーブルに分割されていても、1 テーブルに 2 概念が混在していても表現できます。
もう 1 点は推論可能性です。オントロジーは記述論理(Description Logic)に基づくため、「A は B の一種で、B は C の一種なら、A は C の一種」といった推論を機械が実行できます。矛盾した定義を書けば推論器が検出します。COA が採用するのは OWL 2 で、整合性の検証には HermiT や ELK といった推論器を使う構成です。
応用例: なぜ SQL の精度が上がるのか
LLM にスキーマだけを渡した場合と、オントロジーを渡した場合を比べます。
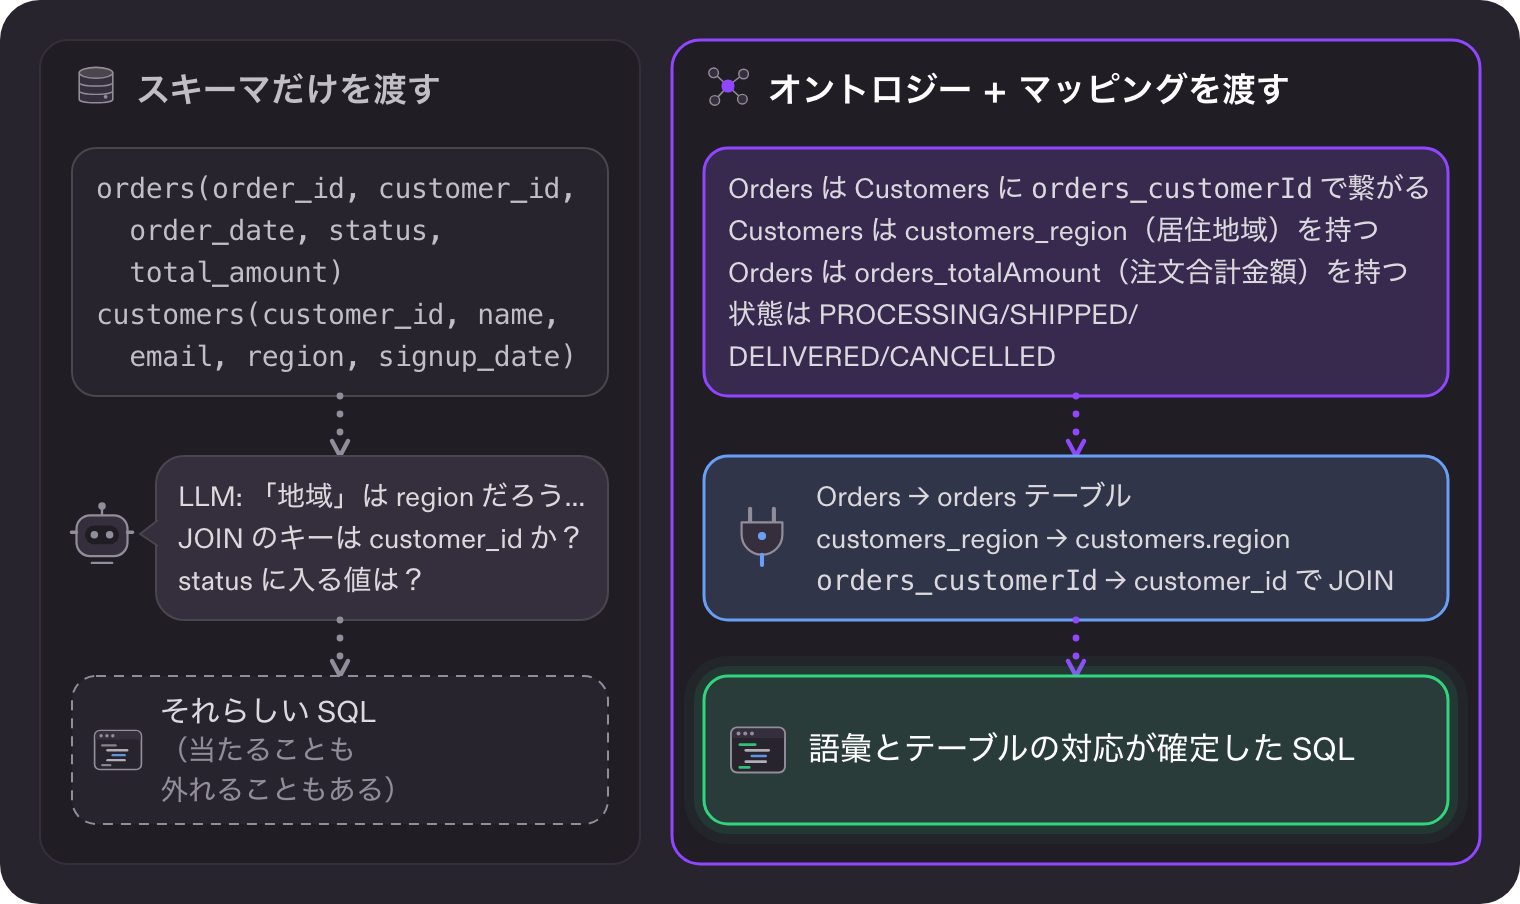
図1: スキーマだけでは推測、オントロジーがあれば対応が確定する
オントロジーが明示するのは、業務語彙とテーブルの対応です。LLM の仕事が「推測」から「与えられた対応関係の適用」に変わるので、スキーマグラウンディングの失敗が減ります。加えてオントロジーには、ER 図にはない業務ルール(キャンセル注文に決済は無い、食品は返品不可)を書けます。これが「テーブル定義に書かれていない知識」を埋める部分です。
用語ミニ辞典
記事に出てくる用語です。深く知らなくても読み進められます。
| 用語 | ざっくり言うと |
|---|---|
| OWL | オントロジーを書くための W3C 標準言語。クラス・プロパティ・制約を表現する |
| Turtle (.ttl) | OWL や RDF を人間が読みやすく書くための記法。「主語 述語 目的語」を並べる |
| RDF / トリプル | 「注文 001 は 顧客 C0001 に 属する」のような 3 つ組でデータを表す形式 |
| ナレッジグラフ | トリプルを積み上げてできる、概念とデータのネットワーク。COA では Amazon Neptune に格納 |
| SPARQL | ナレッジグラフへの問い合わせ言語。SQL のグラフ版 |
| R2RML | 「このクラスはこの物理テーブルのこの列」という対応表の W3C 標準。オントロジーと実データを繋ぐ |
| クラス / プロパティ | クラスは概念(Customer)、object property はクラス間の関係(hasCustomer)、datatype property は属性(hasEmail)。慣例的な命名例で、COA が実際に生成する IRI は後述のとおり元のテーブル名・カラム名を保った形です |
| 推論器(HermiT / ELK) | オントロジーの論理的な矛盾を検出し、暗黙の含意を導くエンジン |
OBDA はオントロジー経由でデータに問う枠組み
COA を理解する鍵となる概念が OBDA(Ontology-Based Data Access)です。
OBDA は「ユーザーはオントロジー(概念層)に対して SPARQL で問い、システムがそれを実データへの SQL に変換して答える」という枠組みで、2010 年代から研究されてきました(Ontop プロジェクトの解説)。概念層と物理層を R2RML マッピングで繋ぐ、という構造です。代表的な実装がオープンソースの Ontop で、SPARQL を SQL に書き換えて既存 RDB に投げます。
つまり「意味の層を通してデータに問う」というアイデア自体は新しくありません。長年のネックは、オントロジーと R2RML マッピングを人間が手で書かなければならなかったことです。数百テーブルの企業データに対してこれを整備し、維持し続けるコストが導入障壁でした。
ここに LLM が効きます。オントロジーの自動生成(ontology learning)は現在活発な研究領域で、LLM による自動構築パイプライン、企業ナレッジグラフ向けの生成手法、ドメイン非依存性の検証など、2026 年に入っても論文が続いています。COA が実装する RIGOR 戦略も、リレーショナルデータベースからのオントロジー生成手法を提案した論文(Nayyeri et al., arXiv:2506.01232)に基づくものです。
COA は「OBDA という確立された枠組み」に「LLM による自動生成」を組み合わせ、AWS のマネージドサービス上で動くようパッケージしたものと捉えると、位置づけがはっきりします。手で書けなかったから普及しなかった仕組みを、生成の自動化で実用ラインに乗せる試みです。
3. COA の仕組み
COA は Scan → Model → Serve の 3 ステップで構成されます。

図2: COA の Scan → Model → Serve の流れ
Scan でデータソースを繋ぎ、意味を補う
データベース(Glue Data Catalog / JDBC)とドキュメント(PDF / DOCX / TXT / MD)を接続します。データベース側はスキーマ発見の後、LLM がメタデータを補完する流れです。列名から業務的な説明・別名・用語集タグを生成し、さらに主キーと外部キーも推論します。
ここは実データで確認した部分です。JDBC ソースなら information_schema から制約を読めますが、Glue Data Catalog には外部キーの概念がありません。実際に Glue の 6 テーブル(customers / products / orders / order_items / payments / shipments)で試したところ、orders.customer_id → customers.customer_id のような参照関係を confidence 0.95 の AI 推論で提示し、5 本の外部キーすべてを正しく当てました。「取れる情報は決定的に取り、取れないものだけ AI が補う」という設計で、JDBC 由来の確定情報(confidence 1.0)は AI 推論より優先されます。
ドキュメント側は、テキスト抽出 → エンティティ抽出 → ナレッジグラフ構築という GraphRAG 系のパイプラインを通る流れです。
Model でオントロジーを生成し、人間が承認する
承認済みのテーブル構造を入力に、LLM が次の 2 点セットを生成します。
- オントロジー本体(OWL / Turtle)。テーブルからクラス、外部キーから object property、列から datatype property を作ります
- R2RML マッピング。各クラスがどの物理テーブルのどの列に対応するかを記述します
この 2 つがセットであることが大事です。オントロジーだけあっても実データには届かず、R2RML があるから概念層から SQL が引けます。前述の OBDA そのものの構造です。
生成戦略は 2 種類あります。既定は埋め込みベースの table_to_ontology(列名を埋め込み、既存オントロジーのクラス・プロパティとベクトル検索で突き合わせる)、もう 1 つが RIGOR 論文実装の rigor_ontology(外部キーのトポロジカル順にテーブルを処理し、生成 LLM が OWL 断片を書き、判定 LLM がレビュー・改稿する)です。
生成物は提案(proposal)として保存され、そのまま本番には入りません。人間が Turtle を確認し、必要なら手修正し、整合性検証(HermiT による論理チェック、構造メトリクス、アンチパターン検出の 3 層)を経て承認します。承認後にナレッジグラフへのマージと埋め込み同期が走る流れです。
グラウンディングという仕組みも入っています。FIBO や Schema.org のような既存の標準オントロジーを読み込んでおくと、生成された新クラスを既存概念と突き合わせ、同じ意味なら rdfs:subClassOf や skos:closeMatch でリンクします。既定モードでは LLM が意味の一致まで検証するため、「名前は同じだが意味が違う」誤マッチ(例: Dublin Core の Policy と保険の policy)は除外される仕組みです。induction を繰り返すたびに同じ概念が別クラスとして増殖する事態を防げます。
Serve は階層的に解決する
自然言語の質問を 3 段階(tier)で解決します。
| Tier | 解決方法 | 得意な質問 |
|---|---|---|
| Tier 1 | 定義済みメトリクスへの直接マッチ | 「今月の売上は?」(指標が定義済みなら決定的に返る) |
| Tier 2 | オントロジーを文脈に NL→SPARQL または NL→SQL を生成して実行 | 「地域ごとの注文合計金額は?」 |
| Tier 3 | ナレッジグラフの意味検索・グラフ探索 + 回答合成 | 「返品は何日以内?」(ドキュメント知識) |
Tier 2 に 2 経路あるのは、SPARQL 経路が VKG(Virtual Knowledge Graph)を通るからです。ここに Ontop が使われ、生成された SPARQL を R2RML に従って SQL へ書き換え、Athena 経由で実データに当てます。もう一方は直接 SQL を生成する経路です。概念層を通す正統な経路と、実用性重視の直接経路を併走させる構成になっています。
設計上の要点が is_mapped です。Tier 2 の対象になるのは「R2RML マッピングを持つクラス」だけで、ドキュメント由来の概念や読み込んだ標準オントロジーのクラスは Tier 3 専用になります。データの裏付けが無いクラスに SQL を書いて空振りする失敗を防ぐための仕組みです。
使われている LLM
すべて Amazon Bedrock 経由で、用途別に使い分けられています。
| モデル | 用途 |
|---|---|
| Claude Sonnet 4.6 | オントロジー生成・グラウンディング |
| Claude Sonnet 5 | Serve のクエリ解決(NL→SPARQL / SQL、回答合成) |
| Claude Haiku 4.5 | メタデータエンリッチ・リランク・文書取り込み |
| Cohere Embed v4 | すべての埋め込み(既定。環境変数で変更でき、Amazon Titan もサポート) |
インフラ構成
構成は 16 の CDK スタックです。主要なものを挙げます。
| レイヤ | 主なリソース |
|---|---|
| 基盤 | VPC、Cognito(または外部 OIDC)、Bedrock Guardrail、Neptune(グラフ)、OpenSearch Serverless(ベクトル)、DynamoDB(ロール・Cedar ポリシー) |
| Scan | Step Functions + Lambda 群(discovery / enrich)、ECS Fargate、Amazon DataZone(カタログ)、Athena ワークグループ |
| Model | ECS Fargate(推論・induction)、VKG(Ontop on Fargate) |
| Serve | Bedrock AgentCore Runtime(Context Manager / MCP Server)、API Gateway + Lambda オーソライザー、CloudFront + S3(Web UI) |
エージェントからの利用は MCP(Model Context Protocol)サーバー経由で、Kiro や Claude Desktop などから接続できます。アプリからは REST、人間は Web UI と、入口は 3 つです。
Neptune と OpenSearch には何が入るのか
「グラフ」と「ベクトル」という役割だけだと中身が想像しづらいので、実際に何が格納されるのかを整理します。
Neptune には 2 種類のデータが、別のモデルで入ります。
構造化データ側(テーブル由来)は RDF の名前付きグラフです。オントロジー 1 つが名前付きグラフ 1 つに対応し、URI は {ベース}/{namespace}/{オントロジーIRIをURLエンコードしたもの} という形になります。namespace どうしの分離は、この URI 接頭辞に対する STRSTARTS フィルタで実現されています。オントロジー全体を横断するカタログ用のグラフは存在せず、クエリのたびに接頭辞で絞る設計です。
中身は OWL のトリプルです。実際に「みどり商店」から生成されたクラスの 1 つを見てみます。
ind:Customers a owl:Class ;
    rdfs:label "customers" ;
    rdfs:comment "Customer master data for Midori EC e-commerce platform,
        containing core customer information including identification,
        contact details, geographic location, and account registration timestamp" ;
    rdfs:subClassOf [ a owl:Restriction ;
        owl:cardinality "1"^^xsd:nonNegativeInteger ;
        owl:onProperty ind:customers_customerId ] ;
    owl:hasKey ( ind:customers_customerId ) ;
    skos:altLabel "EC顧客データ", "customer_master", "顧客マスタ" .
rdfs:comment は AI が生成した業務説明、skos:altLabel は同義語で、日本語の別名がそのまま入っています。主キーが owl:hasKey に、NOT NULL 制約が owl:Restriction の基数制約になっているのも見て取れるはずです。
列は datatype property になります。日本語のカラムコメントが rdfs:comment に入っている例です。
ind:customers_region a owl:DatatypeProperty ;
    rdfs:label "region" ;
    rdfs:comment "居住地域 (8区分)" ;
    rdfs:domain ind:Customers ;
    rdfs:range xsd:string ;
    skos:altLabel "area", "location", "residence_region", "地域" .
そして前回強調した「Glue に無い外部キー」は、こういう形で残っていました。
ind:orders_customerId a owl:ObjectProperty ;
    rdfs:label "customer_id" ;
    scl:fkProvenance "AI_INFERRED" ;
    rdfs:comment "Foreign key: orders.customer_id references customers.customer_id" ;
    rdfs:domain ind:Orders ;
    rdfs:range ind:Customers ;
    skos:altLabel "buyer_id", "purchaser_id" .
scl:fkProvenance "AI_INFERRED" が、この関係が AI 推論由来であることを示しています。information_schema から確定的に取れた外部キーなら、入る値は DETERMINISTIC です。推論で得た関係を、確定情報と区別できる形で保持しています。生成物を見て初めて分かった部分でした。
ここに入るのはスキーマ(クラス・プロパティ・制約)だけで、テーブルの行データは入らない点が大事です。上の Turtle にも顧客 1 件のデータも出てきません。前述の VKG は「オントロジーと R2RML を読んで SPARQL を SQL に書き換える」ことだけを担い、実データは元のデータベースに残ったまま参照されます。だから Neptune を巨大化させずに済みますし、データの二重管理も起きません。VKG コンテナが内部に持つ H2 はマッピング解析用のスキーマ置き場で、実データは入っていません。
対になる R2RML マッピングはこうなっていました。
ind:TriplesMap_Customers a rr:TriplesMap ;
    scl:datasourceId "642c5138-e740-4c8b-ae22-9f595c35a17f" ;
    scl:sourceSchema "midori_ec" ;
    rr:logicalTable [ rr:tableName "\"customers\"" ] ;
    rr:subjectMap ind:TriplesMap_Customers/SubjectMap .

ind:TriplesMap_Customers/SubjectMap
    rr:class    ind:Customers ;
    rr:template "http://coa.amazon.com/namespace/midori-ec/ontology/ec-core#customers/{\"customer_id\"}" .
rr:class ind:Customers が「このクラスは物理テーブル customers に対応する」という宣言で、rr:template は主キーから各行の IRI を組み立てる型です。複合主キーだとこの型が伸びて、order_items は {"order_id"}/{"line_number"} の 2 セグメントになっていました。
この R2RML 自体は Neptune のグラフには載りません。取り込み時にスキャンされて「このクラスは SQL で答えられる」という印だけがグラフに書かれ、マッピング本体は VKG が S3 から読みます。Neptune に入るのはあくまでオントロジーだけ、という切り分けです。
外部キーは JOIN 条件を持った形で入ります。
ind:TriplesMap_Orders/POM_CustomerId
    rr:predicate ind:orders_customerId ;
    rr:objectMap [ rr:parentTriplesMap ind:TriplesMap_Customers ;
                   rr:joinCondition [ rr:child  "\"customer_id\"" ;
                                      rr:parent "\"customer_id\"" ] ] .
前回 Tier 2 で得られた SQL の JOIN customers c ON o.customer_id = c.customer_id は、この rr:joinCondition に対応します。SPARQL 側に結合条件を書かなくても、マッピングから物理的な JOIN が導かれるのが OBDA の仕組みで、その対応表がこれです。
一方ドキュメント側(GraphRAG のパイプライン)は、同じ Neptune クラスタに openCypher のプロパティグラフとして入ります。__Entity__(抽出されたエンティティ)、__Fact__(抽出された事実)、__Statement__(裏付けとなる文)、__Topic__、__Chunk__ といったノードがあり、こちらは概念だけでなく文書から抽出した実際の事実が格納されます。同じクラスタでもアクセス経路が /sparql と /openCypher で分かれており、構造化側とはモデルもクエリ言語も別です。
なお namespace の分離方法も構造化側と違います。RDF 側がグラフ URI の接頭辞で絞るのに対し、こちらはノードラベル自体に namespace の接尾辞が付きます(__Entity__retail__ のような形)。
構造に特徴があって、エンティティ間の関係は __RELATION__ という単一の関係型で結ばれ、実際の述語はそのエッジの value プロパティに入ります。RDF なら述語ごとに別の IRI になるところを、プロパティグラフでは 1 種類のエッジにまとめて中身を属性で持たせる形です。模式的に書くとこうなります(形を示すための例で、実際に格納された値ではありません)。
(:__Entity__ {value: ..., class: ...})
  -[:__RELATION__ {value: "<LLM が抽出した述語>"}]->
(:__Entity__ {value: ..., class: ...})
エンティティの裏付けとなる原文は __SUBJECT__ / __OBJECT__ → __SUPPORTS__ と辿って __Statement__ の value に到達します。前回 Tier 3 で回答に引用元が付いていたのは、この経路を辿って原文まで戻れるからです。
つまり同じ Neptune の中に「テーブルのスキーマだけを持つ RDF」と「文書の中身を持つプロパティグラフ」が同居していて、モデルもアクセス方法(/sparql と openCypher)も別です。前回の Tier 3 で「返品ポリシーの文書と用語集の文書を跨いで答えた」のは、後者を辿った結果でした。
OpenSearch にはベクトルと、検索用のメタデータが入ります。
インデックスは namespace ごとに 1 本で、その中にオントロジーのクラス・プロパティと、定義済みメトリクスが同居します。1 ドキュメントのフィールドはこうです。
| フィールド | 役割 |
|---|---|
entity_uri |
クラス/プロパティの IRI。メトリクスは urn:coa:{namespace}:metric:{名前} という専用の URN |
ontology_id |
どのオントロジーのものか |
entity_type |
class / property / metric
|
embedding_type |
埋め込みの種類 |
model_id |
埋め込みに使ったモデル |
namespace |
どの namespace のものか |
text |
埋め込みに使ったテキストそのもの |
context_text |
(条件付き) NL→SQL のプロンプト用の詳しいスキーマ情報。埋め込みには使わない。text と同じ内容になる場合は書かれない |
data_source_id |
(条件付き) R2RML 由来のデータソース ID。構造化(Tier 2 で答えられる)クラスにだけ書かれる |
embedding |
ベクトル。既定は 1024 次元(Cohere Embed v4) |
1 件はこんな形になります(orders クラスの場合。フィールド構成は実装どおりで、text / context_text の中身は要点だけを抜いた形にしています)。
{
  "entity_uri": "http://coa.amazon.com/namespace/midori-ec/ontology/ec-core#Orders",
  "entity_type": "class",
  "namespace": "midori-ec",
  "data_source_id": "642c5138-e740-4c8b-ae22-9f595c35a17f",
  "text": "Table: orders | Description: Central transaction record ... | Columns: order_id, status, total_amount, ...",
  "context_text": "Table: orders | ... | Columns: status:string ... allowed values: [PROCESSING, SHIPPED, DELIVERED, CANCELLED]",
  "embedding": [0.0123, -0.0456, ...]
}
text と context_text は分かれています。検索のためにベクトル化するのは text だけで、列の型や取りうる値は context_text に入れて、あえて埋め込みません。
違いは上の例に出ています。context_text の側にだけ allowed values: [PROCESSING, SHIPPED, DELIVERED, CANCELLED] が入っています。これは実データをサンプリングして得た値で、SQL を書くときには「status に入るのは SHIPPED で、shipped ではない」と知る必要がある一方、検索のベクトルに混ぜるとノイズになって関連するテーブルを見つけにくくする、という判断です。「探すための情報」と「書くための情報」を分けている、と読めます。
前回 Tier 2 で日本語の「地域ごとの注文合計金額」が customers.region に結びついたのは、この text の側に列名と業務説明・同義語(地域 を含む)が入っていて、質問の埋め込みと近くなったからです。
ドキュメント側は別のインデックスで、chunk_{namespace} と topic_{namespace} の 2 本が作られます。オントロジー側とはスキーマも命名も別系統です。__Statement__ はグラフには作られるもののベクトル化はされません。ベクトル索引を引く経路が無いので、埋め込みのコストだけかかって検索の役に立たないという判断です。
なお HNSW の ef_construction や m といったパラメータは指定されていません。OpenSearch Serverless の新世代(NEXTGEN)のベクトル検索コレクションが knn_vector への明示的なエンジン指定を受け付けず、Faiss/HNSW に自動解決されるためです。結果として設定できるのは「k-NN を有効にする」と「次元数」の 2 つだけで、シャード数もサーバーレス側の管理に委ねられます。チューニングの余地が意図的に小さい構成です。
4. 機能を画面で見る
ここからは実際の画面で各機能を解説します。題材は架空の EC サイト「みどり商店」で、Glue に 6 テーブル(カラムコメントは日本語)、ドキュメントは業務用語集・返品ポリシー・配送 SLA の 3 本を用意しました。
サインインとナビゲーション
サインインは Cognito のホスト UI に委譲されます(外部 OIDC IdP への差し替えも設定で可能)。
図3: サインインは Cognito のホスト UI に委譲される
ログイン後、左のナビゲーションが機能の全体像そのものになっています。Sources(Scan)→ Induction / Explorer(Model)→ Playground(Serve)という流れで、上から順に使う設計です。

図4: 左ナビの並びが機能の全体像になっている
Namespaces はマルチテナントの単位
すべての作業は namespace(作業空間)の中で行います。namespace ごとにデータソース・オントロジー・アクセス権が完全分離されるマルチテナント設計で、「部門ごと」「ドメインごと」に切るのが想定用途です。
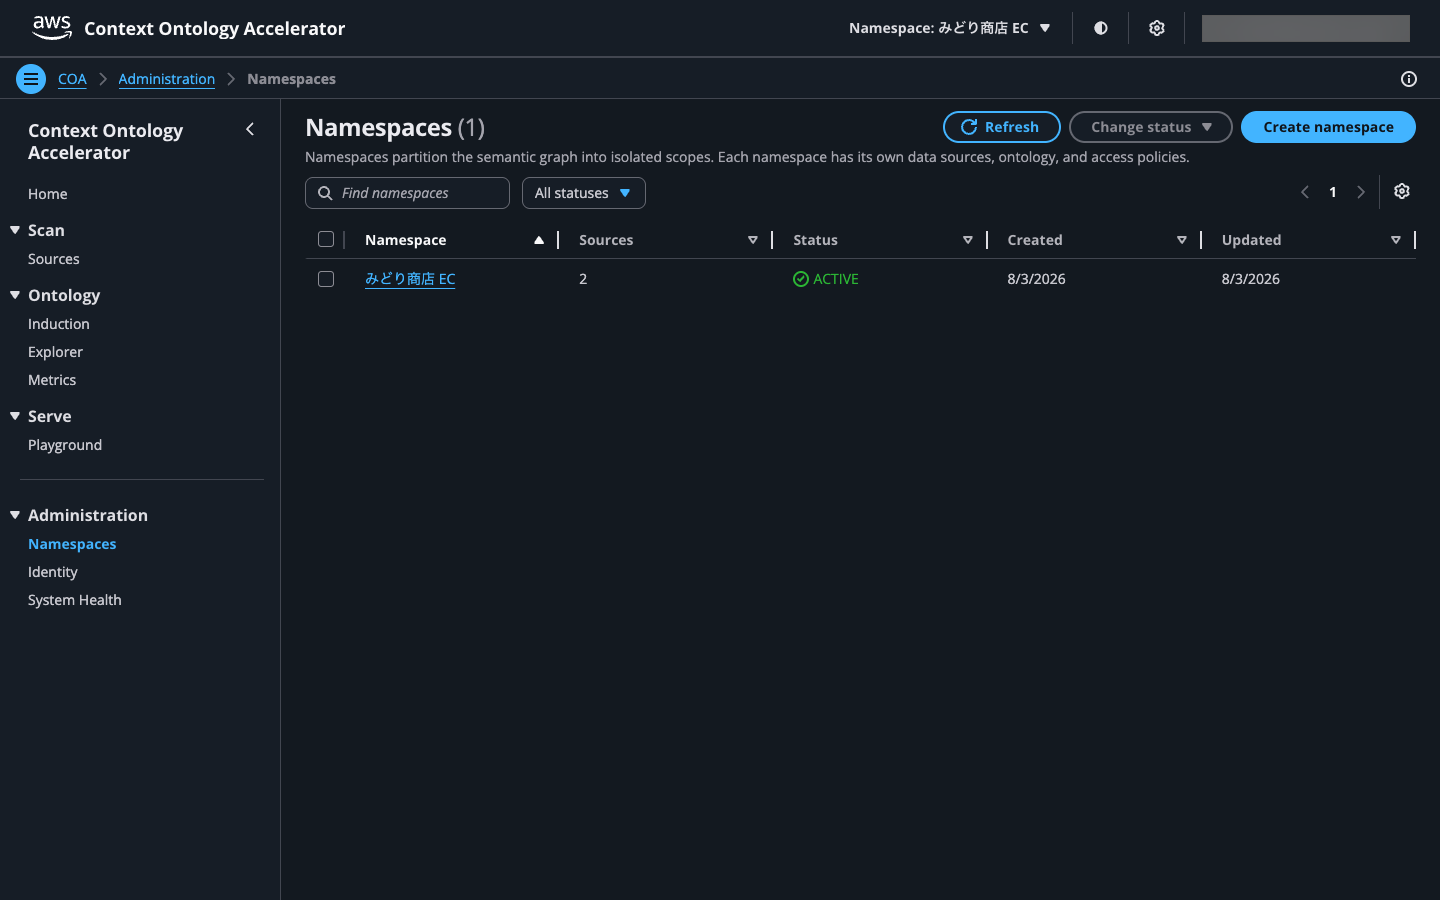
図5: 作業空間となる namespace の一覧
作成フォームは名前・表示名・説明・オーナーのみのシンプルな構成です。
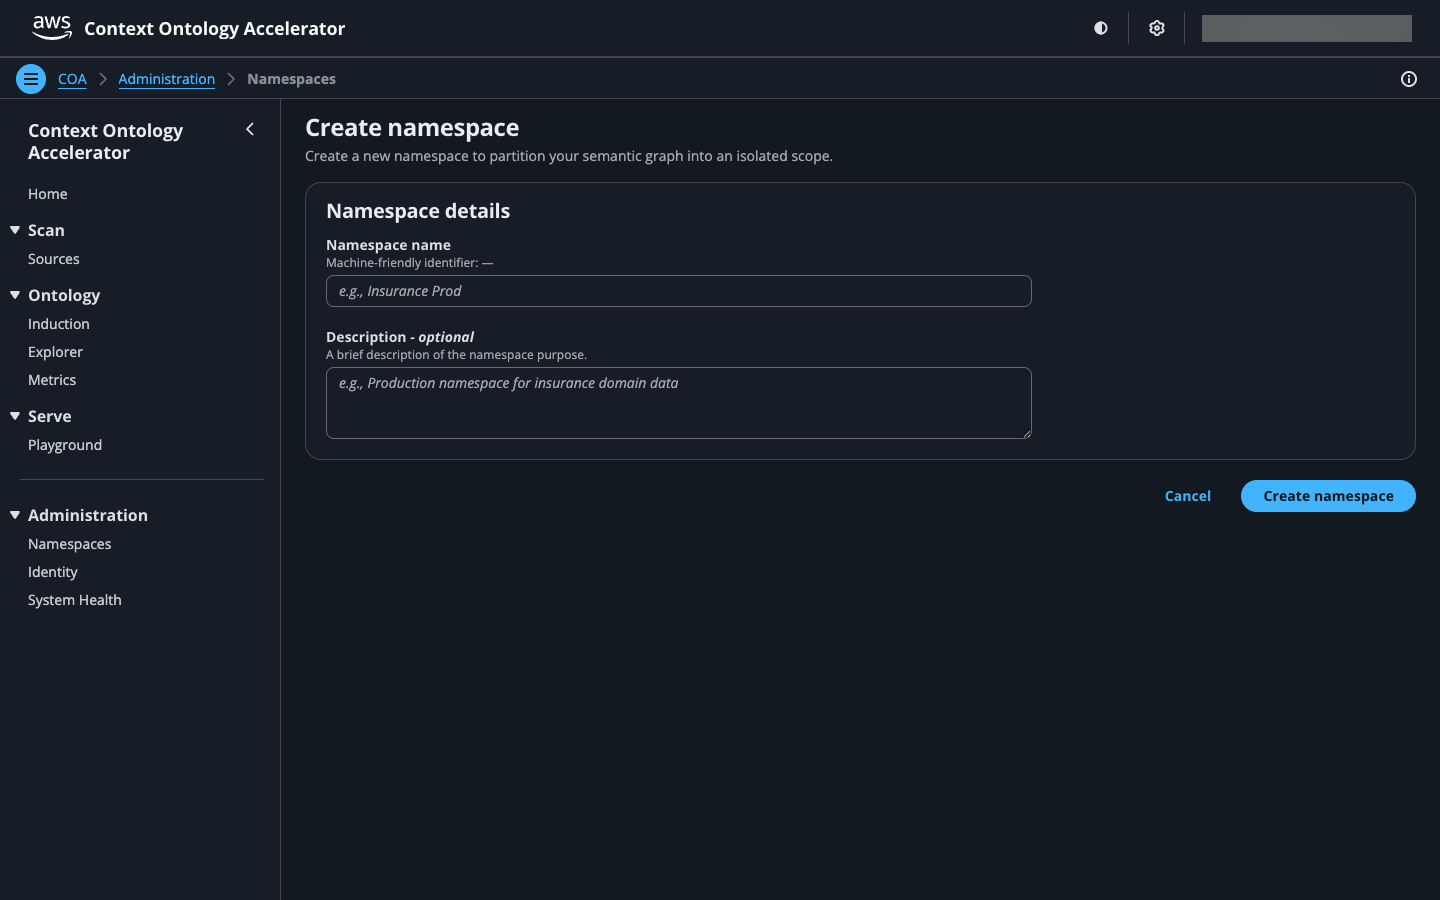
図6: namespace の作成フォームは 4 項目だけ
作成すると、裏で Amazon DataZone のプロジェクトと専用の Athena ワークグループが自動プロビジョニングされます。クエリの実行環境まで namespace 単位で分離されます。
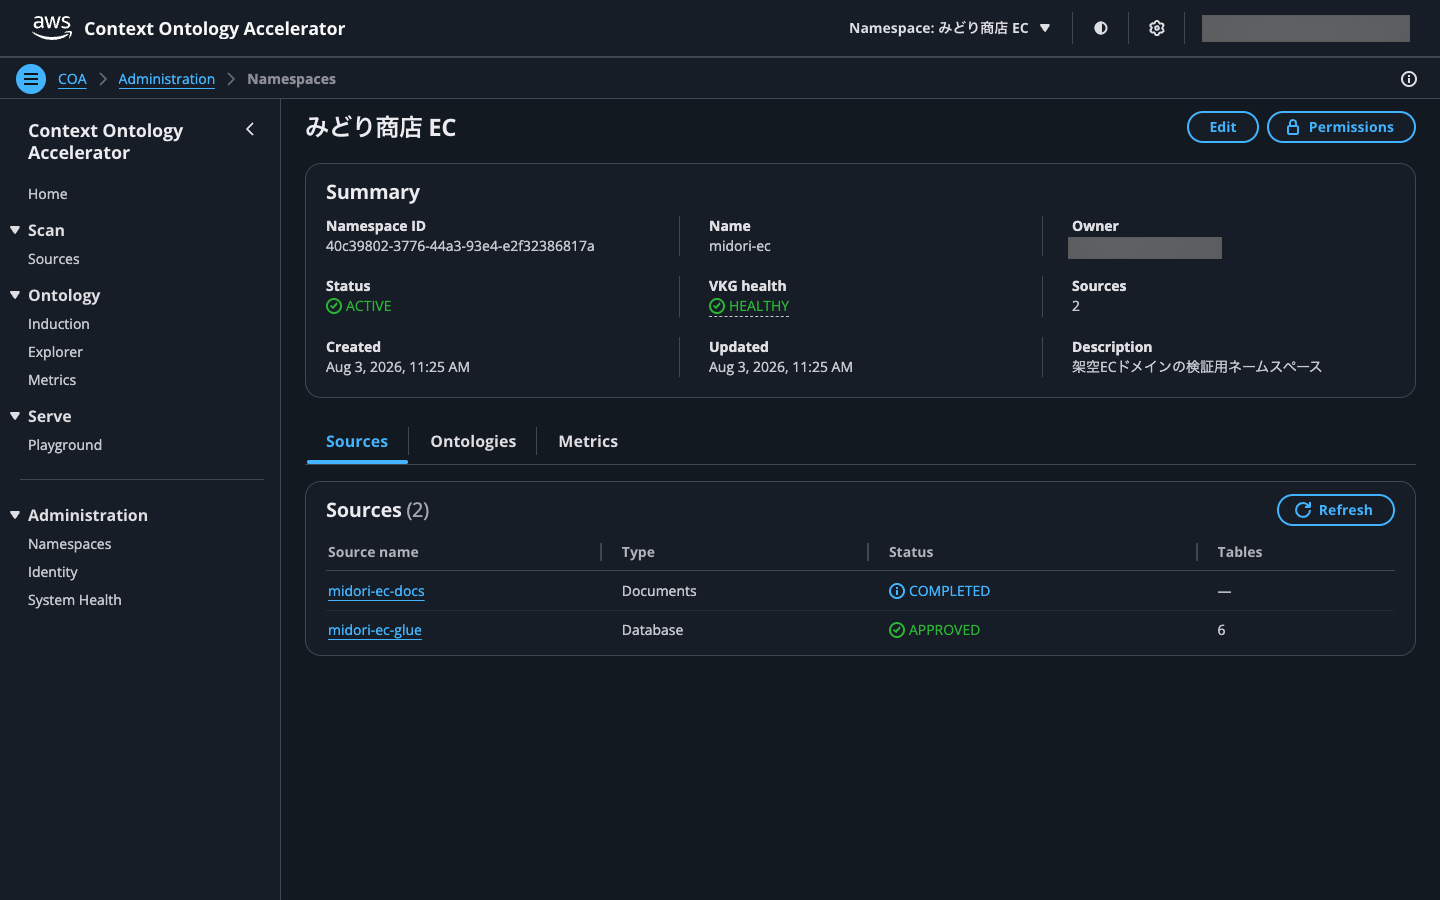
図7: namespace 詳細のサマリー
Sources で接続できるデータソース
対応するのは 2 種類 4 サブタイプです。
| 種類 | サブタイプ | 内容 |
|---|---|---|
| DATABASE | GLUE_DATABASE | Glue Data Catalog のデータベース |
| DATABASE | JDBC_DATABASE | PostgreSQL / MySQL / Redshift / SQL Server(Secrets Manager で認証) |
| DOCUMENTS | S3 | S3 バケットのプレフィックス |
| DOCUMENTS | LOCAL_UPLOAD | 画面からのファイルアップロード(PDF / DOCX / TXT / MD、1 ファイル 200MB まで) |
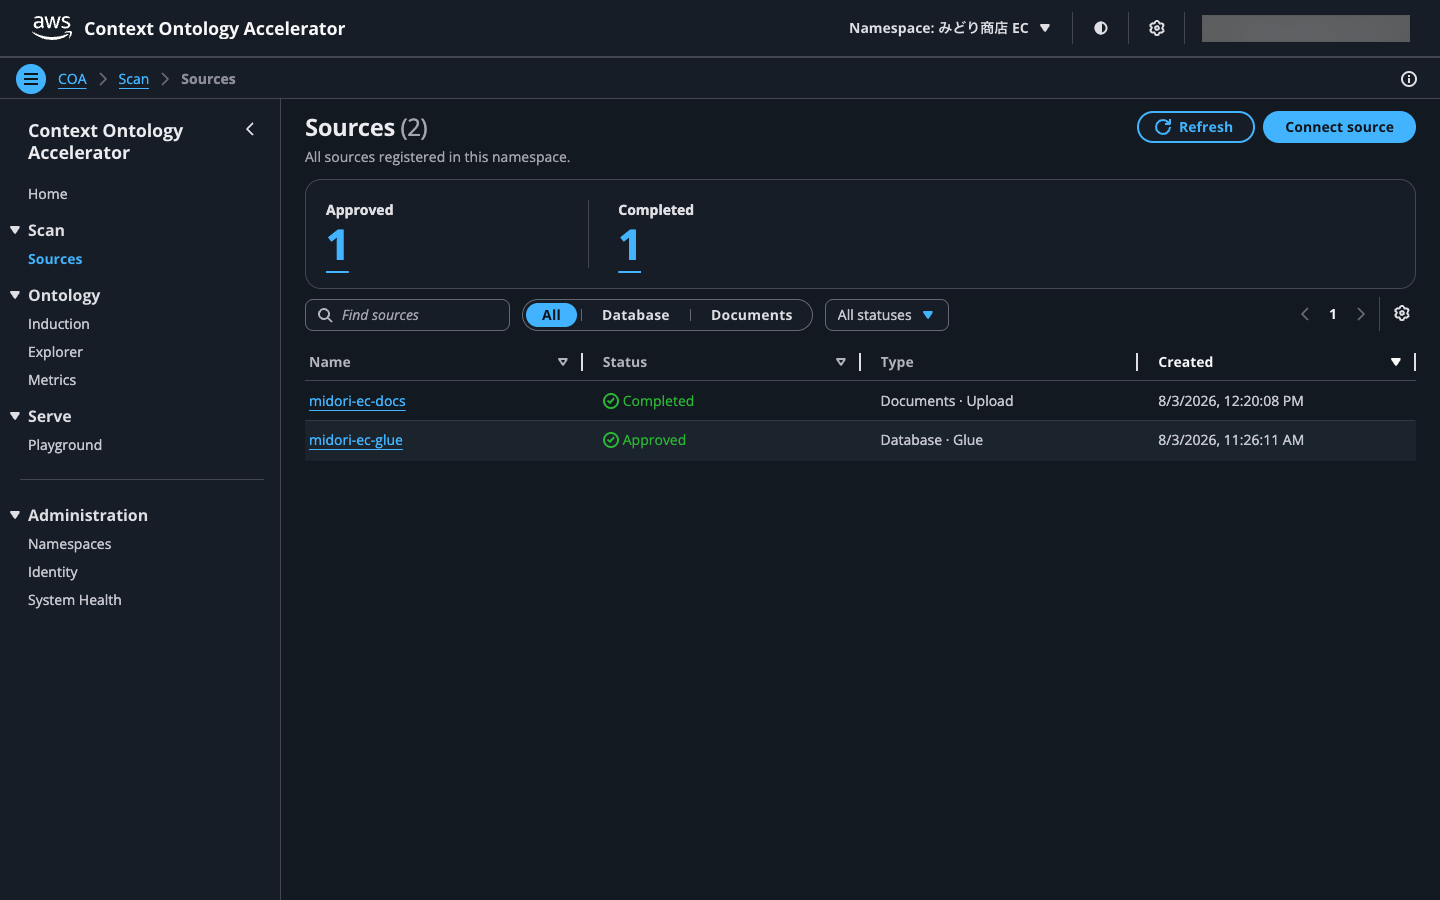
図8: Glue とドキュメントの 2 ソースを登録した状態
ソース接続フォームに何を入力するのか
「Connect source」から接続します。最初にソース種別を選び、種別ごとの設定へ進む 2 段構成です。

図9: 最初にソース種別を選ぶ
Glue を選んだ場合の入力は、カタログ ID・リージョン・データベース名が必須で、あとは任意項目です。テーブルフィルタ(正規表現)が用意されているのが実務的で、orders|customers で対象を絞ったり、tmp_.*|staging_.* で作業用テーブルを除外できます。大規模カタログをそのまま流し込まずに済みます。クロスアカウントのカタログを読む場合は、引き受ける IAM ロール ARN と ExternalId も指定できます(ロール名は {prefix}-datasource-access-* という命名規約が要求されます)。
JDBC を選ぶと接続情報の入力になります。
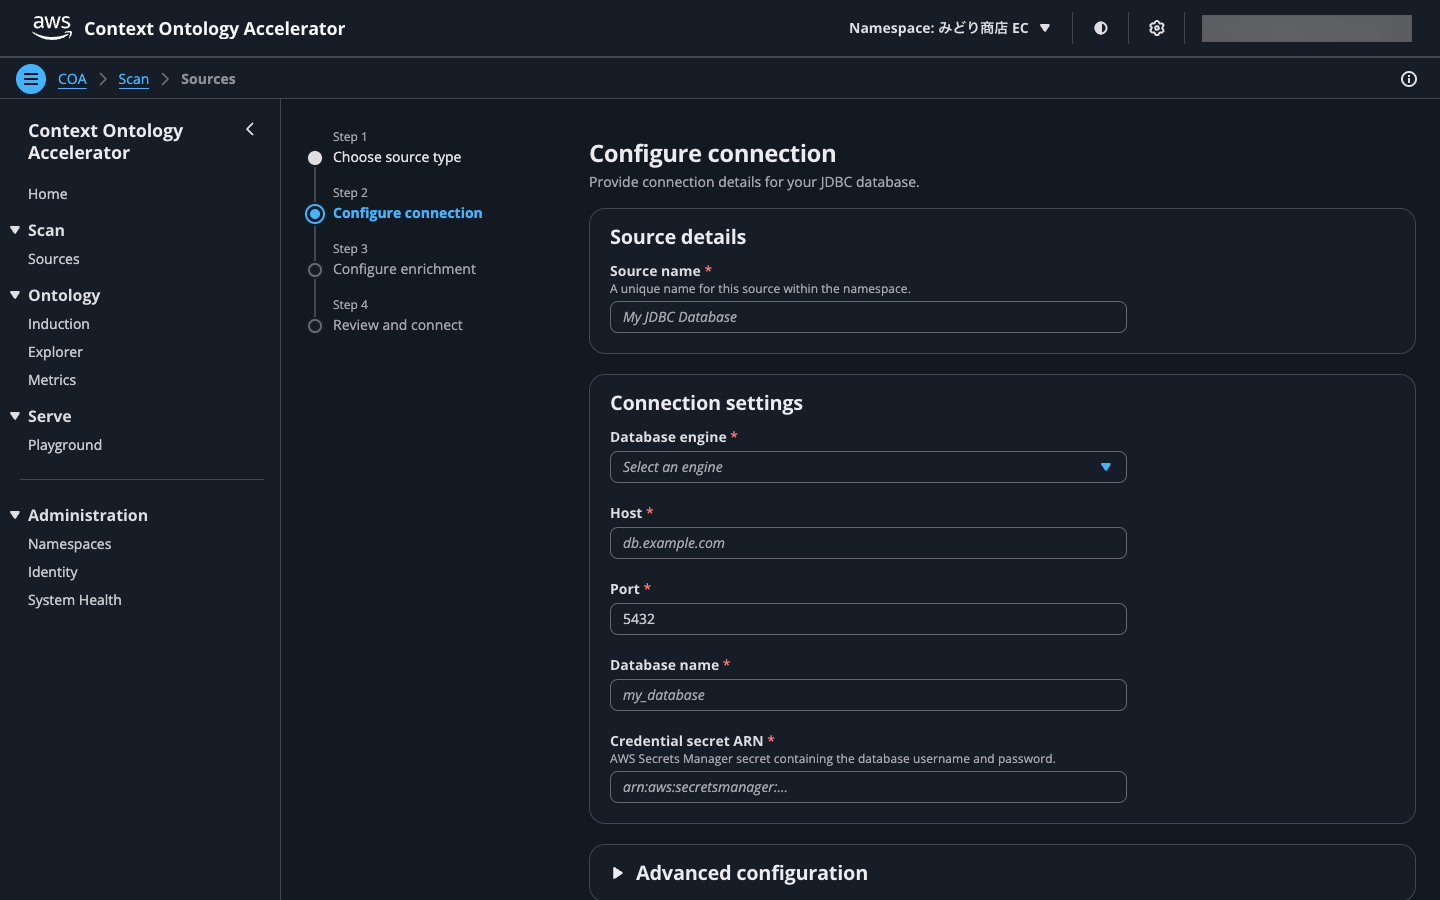
図10: JDBC の認証情報は Secrets Manager ARN で渡す
エンジンを選ぶとポートが既定値(PostgreSQL なら 5432)で埋まります。パスワードを直接入力する欄はなく、AWS Secrets Manager のシークレット ARN を指定する方式です。認証情報が COA 側に保存されない設計になっています。スキーマフィルタはグロブ(* ? [seq])で、| や , 区切りの複数指定も可能です。
登録すると自動でスキャンが始まります。実測では Glue 6 テーブルの discovery + AI エンリッチが約 30 秒、ドキュメント 3 本のナレッジグラフ構築が約 2 分でした。
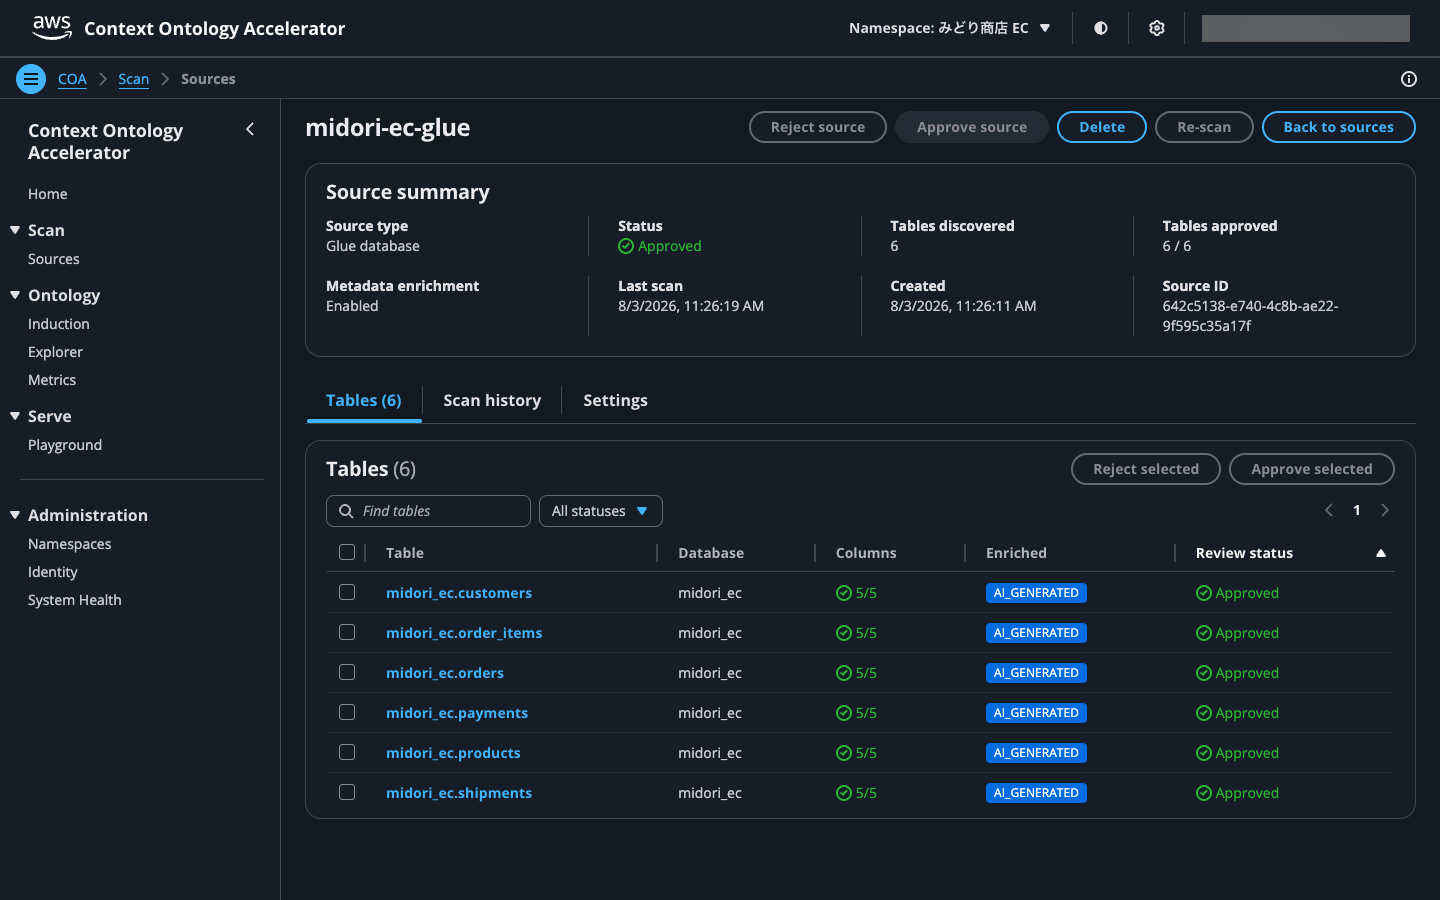
図11: 6 テーブルすべてが AI エンリッチ済みで承認された
テーブル詳細で AI 生成のメタデータをレビューする
テーブル名をクリックすると詳細画面が開きます。Scan フェーズの中心となる画面で、AI が生成した業務メタデータを人間がレビューする場所です。
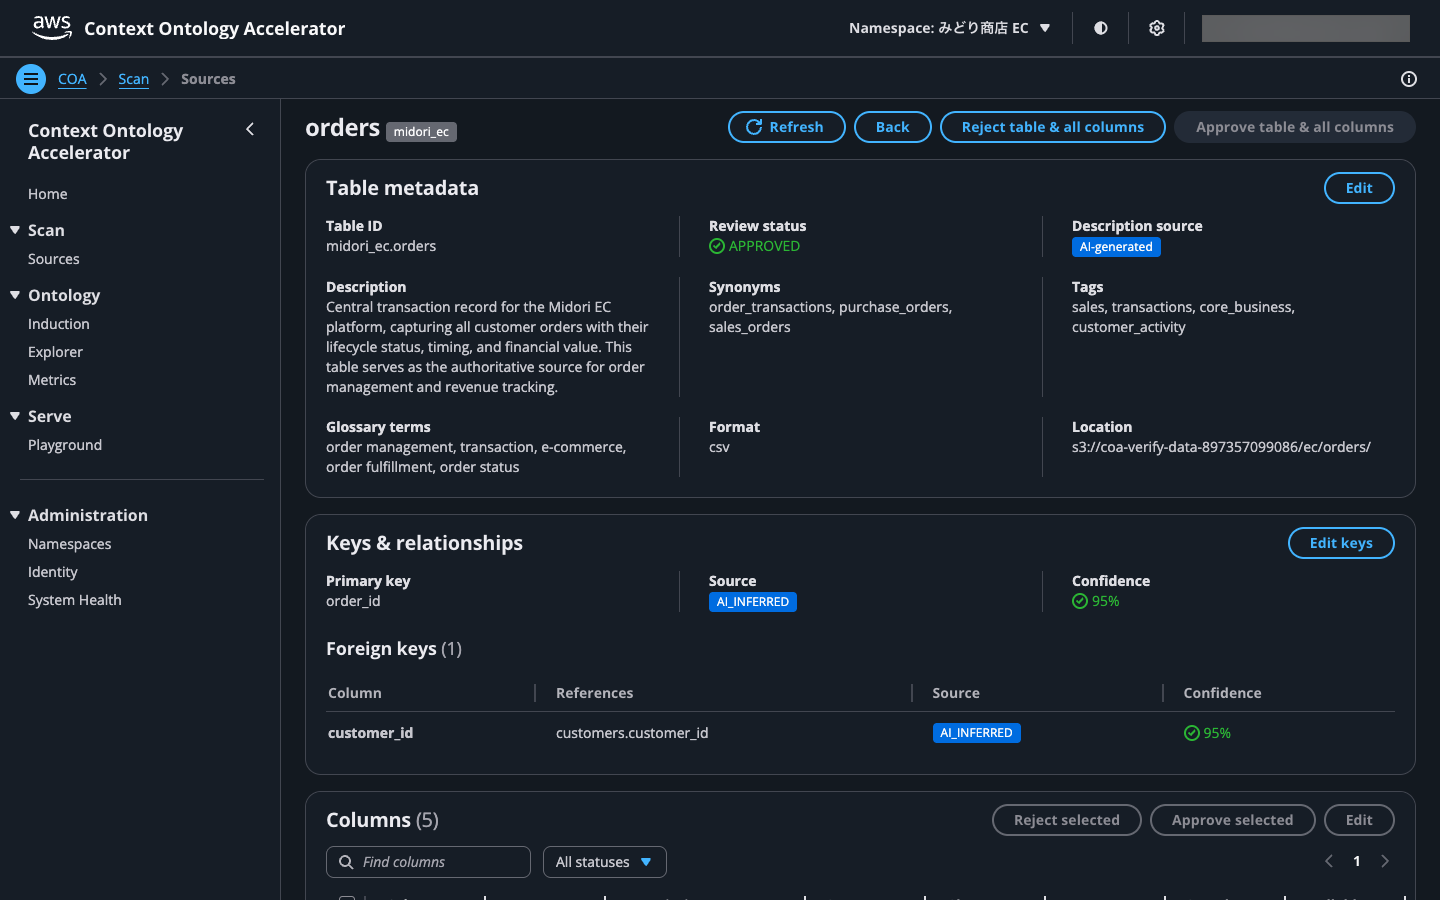
図12: カラムごとに AI 生成の説明と信頼度をレビューする
画面の構成が COA の思想をよく表しています。カラムごとに説明・別名・用語集タグ・サンプル値・生成元(AI_GENERATED / DETERMINISTIC / STEWARD_EDITED)・confidence・レビューステータスが並び、テーブル単位・カラム単位で承認 / 却下できます。説明文は手で直せて、直すと生成元が「人間が編集した」に変わる仕組みです。
「Keys & relationships」セクションが前述の外部キー推論結果です。承認済みのテーブルだけが次の induction に進めるというゲート構造になっており、AI の出力が人間の確認を経ずにオントロジーへ流れ込むことはありません。
Induction でオントロジーを生成する
Model フェーズの入口です。承認済みテーブルを選んで induction を起動し、生成された提案(proposal)をレビュー・承認します。
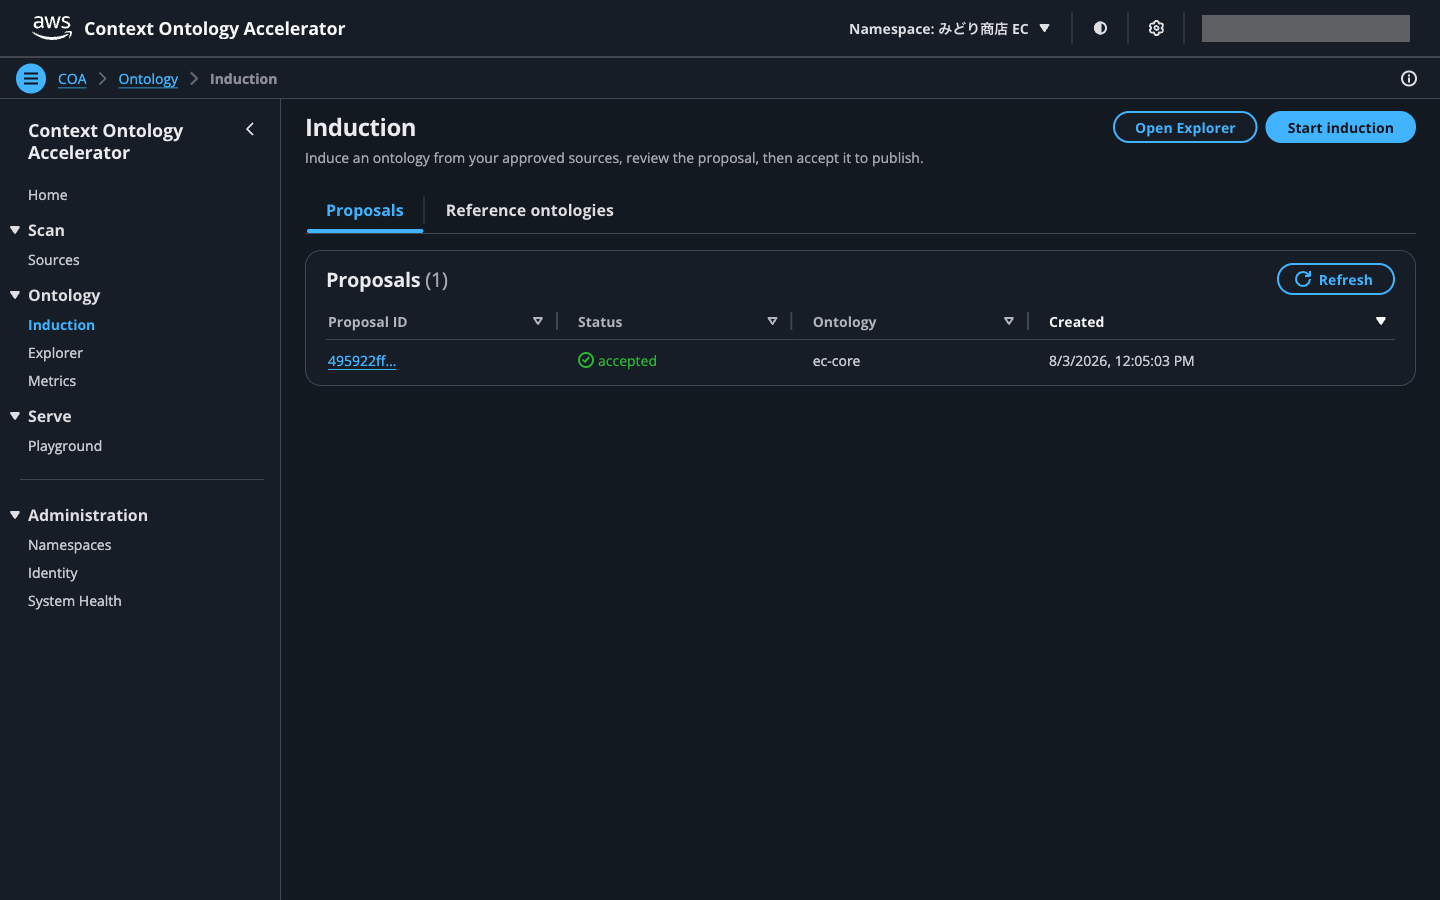
図13: Induction で起動と proposal のレビューを行う
実測では 6 テーブルで約 30 秒、生成内容は次の通りでした。
- 6 クラス:
Customers/Orders/OrderItems/Products/Payments/Shipments - 5 つの object property:
orders_customerId、payments_orderIdなど(外部キー由来の関係) - 25 の datatype property:
customers_email、customers_region、orders_totalAmountなど(列由来の属性) - R2RML マッピング: 6 テーブル分の対応表
生成される IRI は、クラスがテーブル名の PascalCase(orders → Orders)、プロパティが {クラス名}_{カラム名} という規則です。hasEmail のような動詞形ではなく、元のテーブル名・カラム名を保った命名になります。単数化もしないので orders は Order ではなく Orders です。
なお戦略は選択できますが、まずは既定の戦略で試すのがおすすめです。RIGOR 戦略は生成品質に期待できる反面、LLM 呼び出し回数が増えます。
proposal 詳細で生成物を確認して承認する
「AI が起案し、人間が承認する」という本記事の主題が、画面としてどう見えるかがこれです。
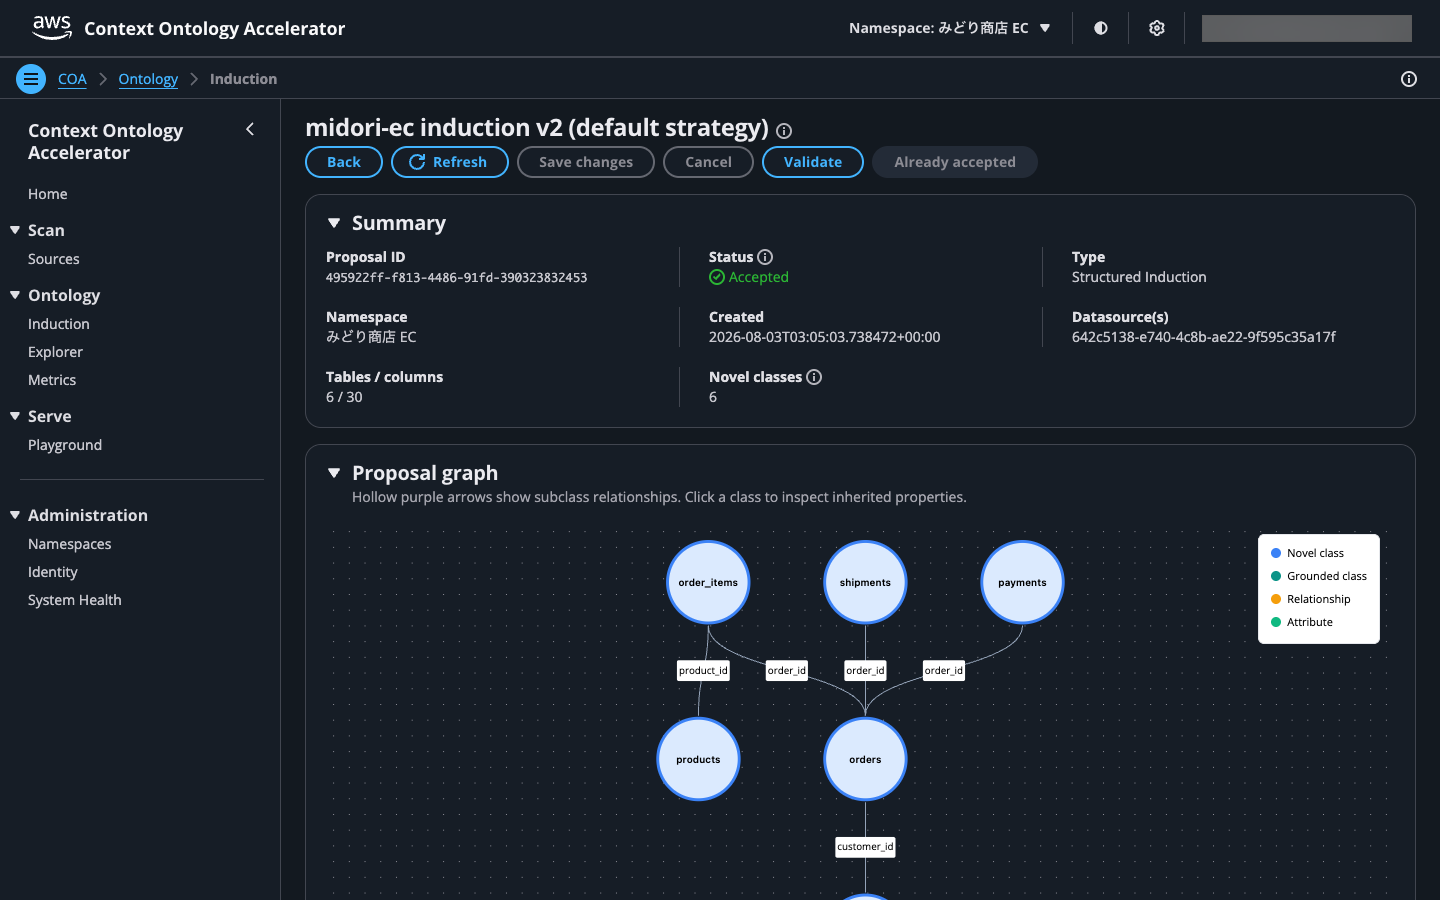
図14: proposal には Turtle、R2RML、SHACL 制約が揃う
画面には次の情報が揃っています。
- Summary: proposal ID・ステータス・元データソース・対象テーブル / カラム数
- Novel vs grounded: 新規に起こされた概念と、既存オントロジーにグラウンディングされた概念の内訳
- Proposal graph: クラス・object property・datatype property の数と最大階層深さ
- Proposed classes: 生成された 6 クラスの一覧(クリックで詳細)
- Ontology Source (Turtle) と R2RML Mapping: 生成物そのもの。ここを直接編集できます
- SHACL Constraints: 制約の一覧。今回は 44 件がアクティブでした
SHACL 制約が自動で 44 件も生成されていたのは想定外でした。SHACL は RDF データの検証ルールを書く W3C 標準で、「この属性は必須」「値はこの範囲」といったデータ品質ルールを表現します。列の NOT NULL 制約やデータ型から機械的に導出できるものに加え、LLM に意味的な制約を推論させるボタン(Infer constraints)も用意されています。
validation で 3 層の検証を実行する
「Validate」を押すと走るのが整合性チェックです。ツールチップに「読み取り専用の品質チェック。proposal は変更しない」と明記されているので、気軽に実行できます。
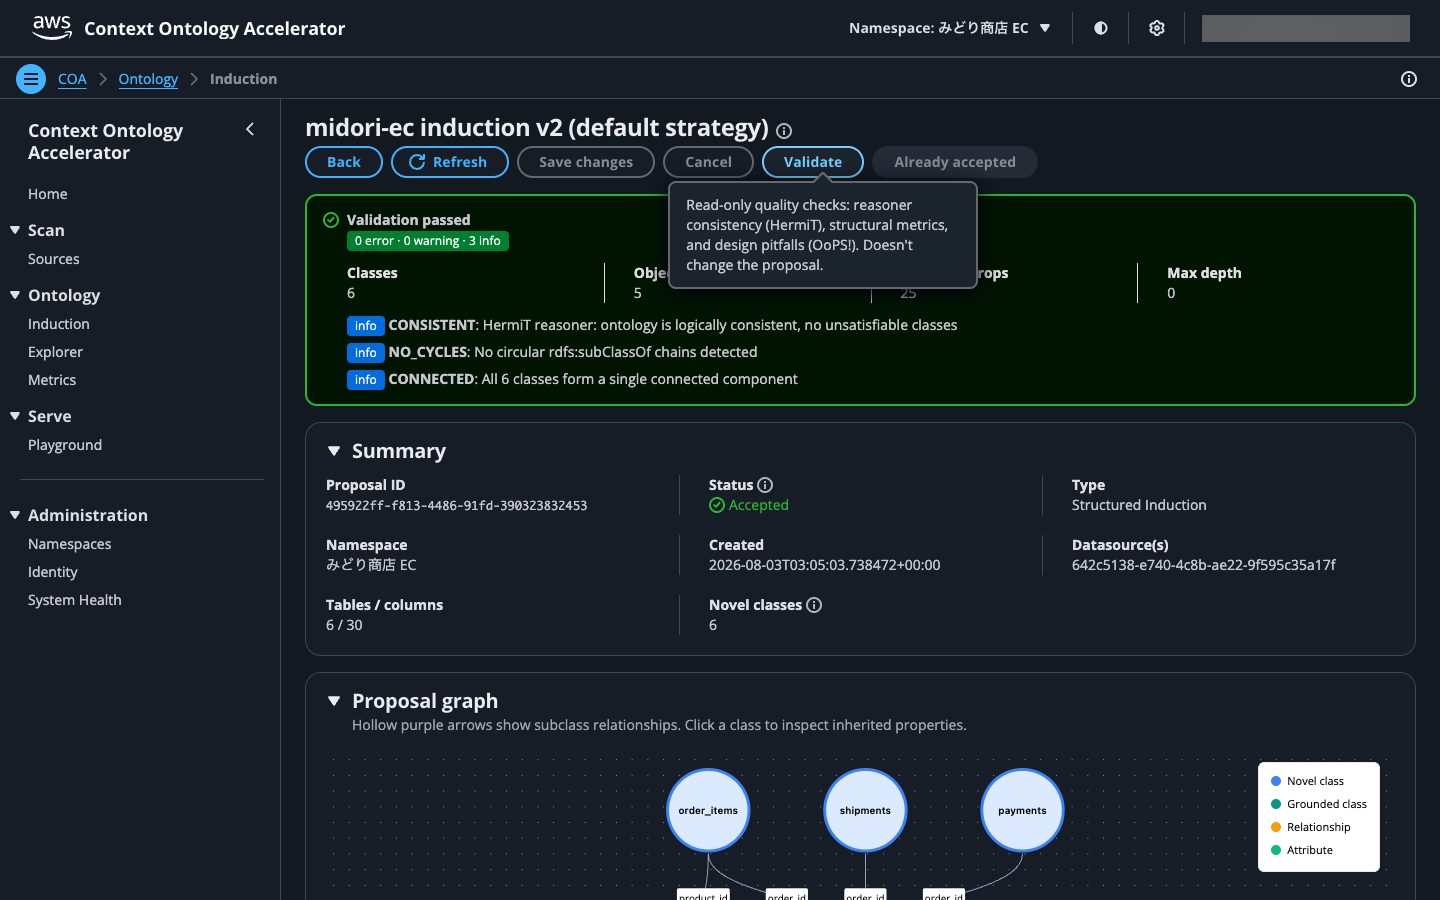
図15: HermiT による整合性検証が通った
実行すると約 30 秒で結果が出ました。
HermiT reasoner: ontology is logically consistent, no unsatisfiable classes
HermiT による論理的整合性の検証が通り、充足不可能なクラス(定義が矛盾していて実体を持ち得ないクラス)が無いことが確認できました。これに加えて構造メトリクス(OntoQA)と設計アンチパターン検出(OoPS!)の 3 層で検証されます。
LLM が生成したオントロジーを推論器で機械検証できるのは、形式オントロジーを採用していることの直接的な利点です。メトリクス定義型のセマンティックレイヤーには無い品質保証の層です。
承認すると Neptune へのマージと埋め込み同期が走り、1 分弱で反映されました。
Explorer で生成されたクラスとグラフを確認する
Classes / Ontologies / Inducted sources の 3 タブで、namespace 内の資産を確認します。

図16: Customer クラスに AI 生成の業務説明が付く
日本語のカラムコメントを入力にしたのに、生成されたクラス説明は自然な英語の業務記述(「Customer master data for Midori EC e-commerce platform...」)になっていました。文脈を踏まえた内容で、そのままデータカタログの説明として使えそうな水準です。
行を選択するとクラス詳細が開き、関係と属性(Relationships / Attributes)が確認できます。customers クラスなら関係 1 件(注文からの参照)と属性 5 件でした。
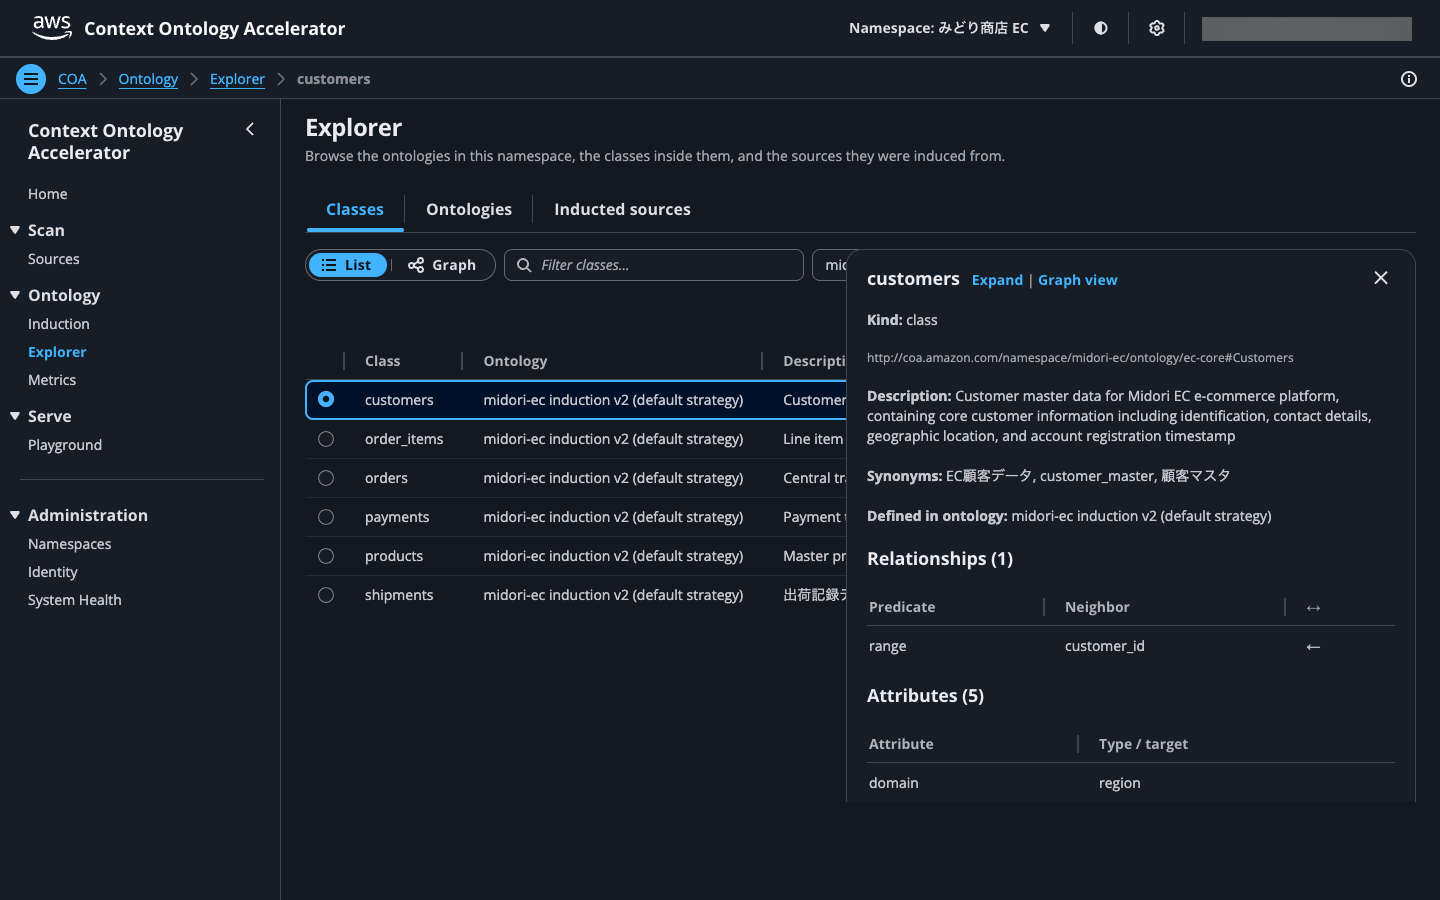
図17: customers クラスの関係 1 件と属性 5 件
「Graph」ボタンでグラフビューに切り替えると、クラスと関係が可視化されます。Order を中心に Customer / OrderItem / Payment / Shipment が繋がる様子が一目で分かり、レビューにも社内説明にも使えます。
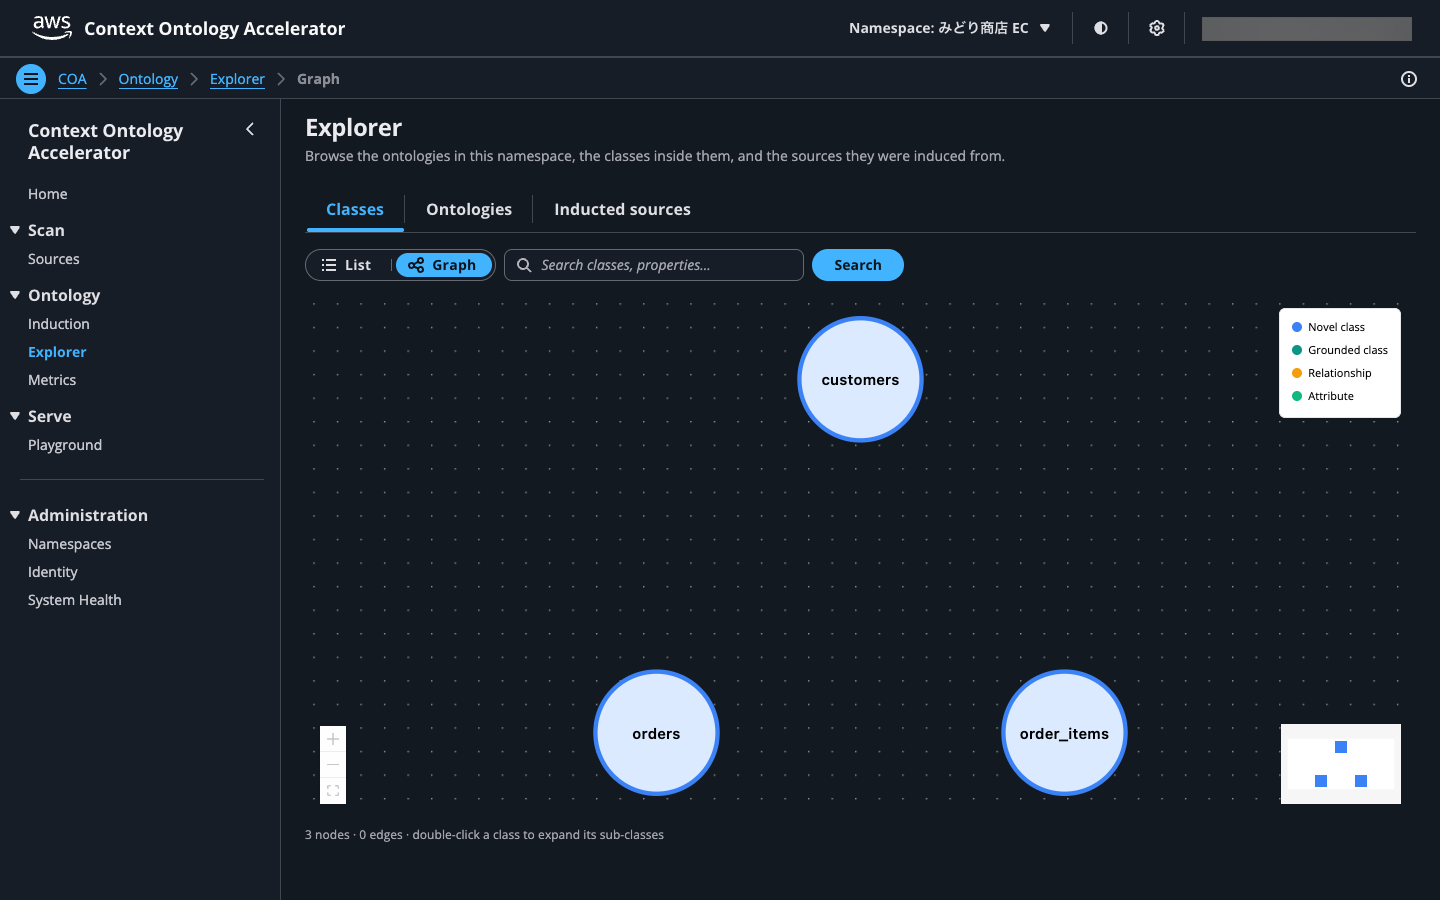
図18: 6 クラスと関係をグラフで確認できる
Ontologies タブは namespace 内のオントロジーの棚卸し用です。種別(Induced / Foundational / Uploaded)で絞り込めるほか、クラス数・プロパティ数・公理数が一覧に出るので、induction を重ねたときの規模の変化を追えます。今回の induced オントロジーはクラス 6・プロパティ 30・公理 308 でした。
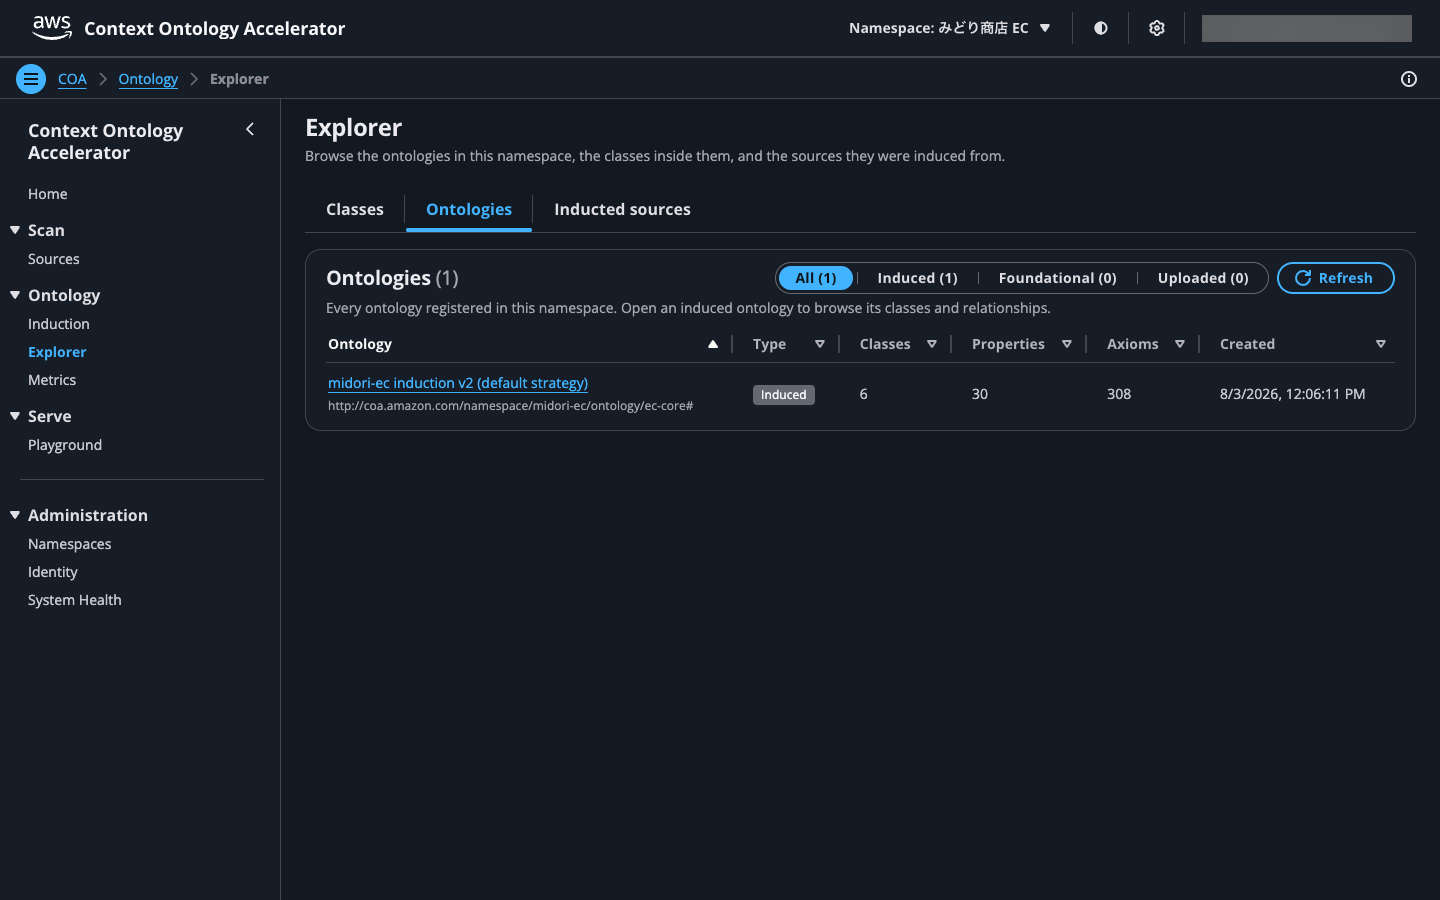
図19: induced オントロジーはクラス 6、公理 308
Metrics で指標を定義する
「売上 = DELIVERED 注文の合計金額」のようなガバナンス済み指標を定義する画面です。定義済み指標は Serve の Tier 1 で最優先マッチされます。
作成フォームの入力項目が、この機能の性格をよく表しています。
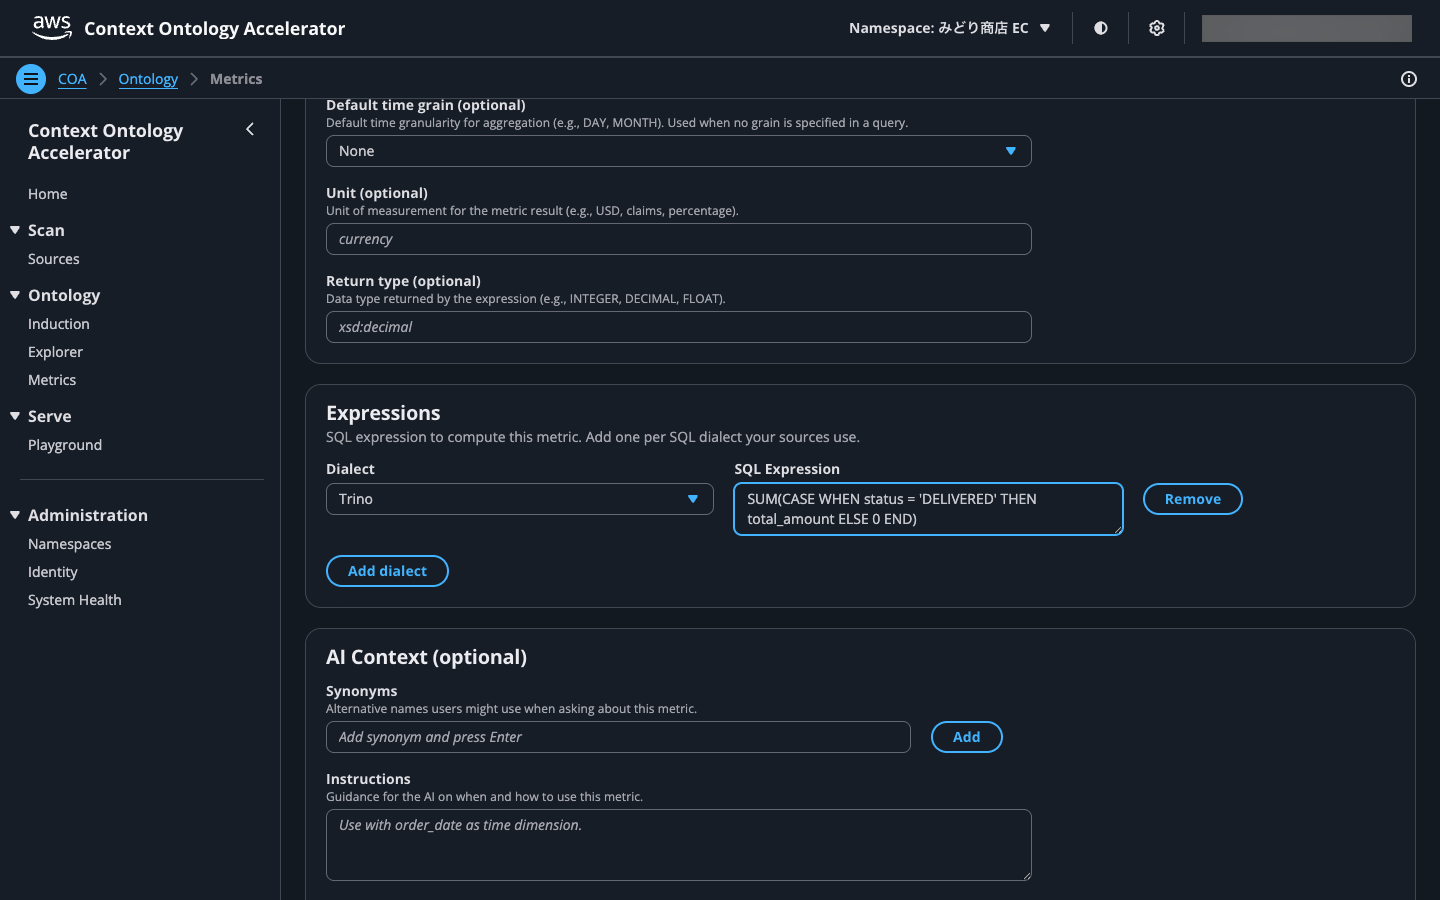
図20: メトリクスは SQL 方言ごとに式を登録する
- Basic information: 名前・説明
- Source: データソースとテーブルをドロップダウンで選択(登録済みソースから選ぶ)
- Expressions: SQL 方言ごとに式を登録します。選択肢は PostgreSQL / Trino / Redshift / Snowflake / Databricks / MySQL。Athena は Trino 方言です
- 単位・戻り型・既定の時間粒度: 任意項目
- AI 向けコンテキスト: 同義語、AI への指示、想定質問例
- Ontology classes: オントロジーのクラスに紐付け
AI 向けコンテキストの欄が特徴的です。「この指標をどう計算するか」だけでなく「ユーザーがどう呼ぶか」「AI がいつ使うべきか」まで書けるようになっています。
実際に「配達完了注文の合計金額」を total_revenue として定義しました。詳細画面では登録した SQL 式が方言ごとに確認できます。

図21: total_revenue の Trino 方言の式
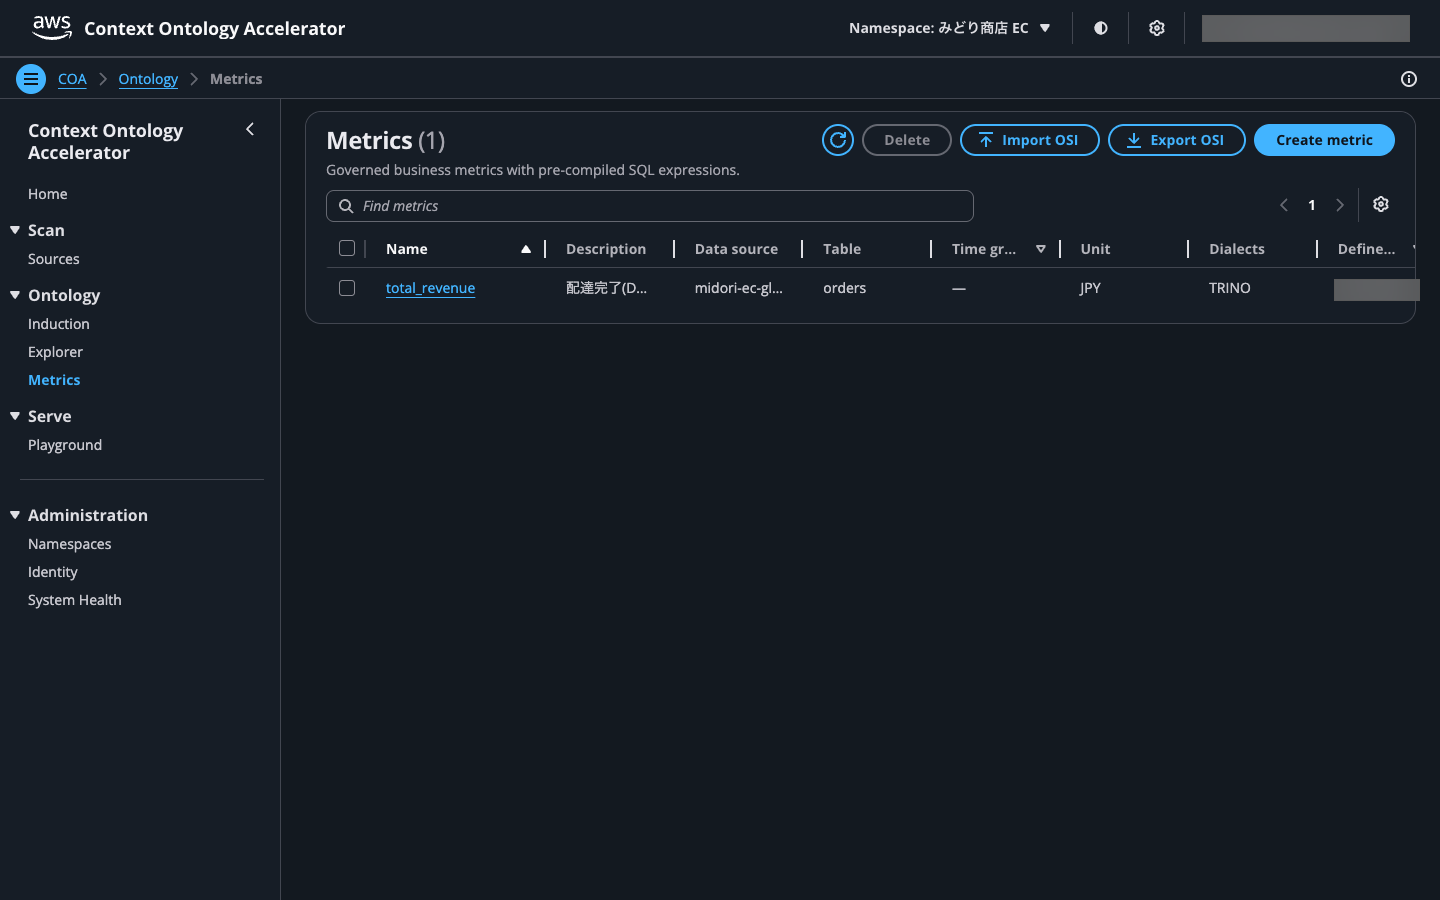
図22: 登録済みの total_revenue
Playground から自然言語で問い合わせる
Serve の動作確認画面です。質問するとストリーミングで解決過程と結果が返ります。実際の検証結果は次章で詳しく扱いますが、画面としては結果テーブルと実行されたクエリが並んで表示されるのが特徴です。
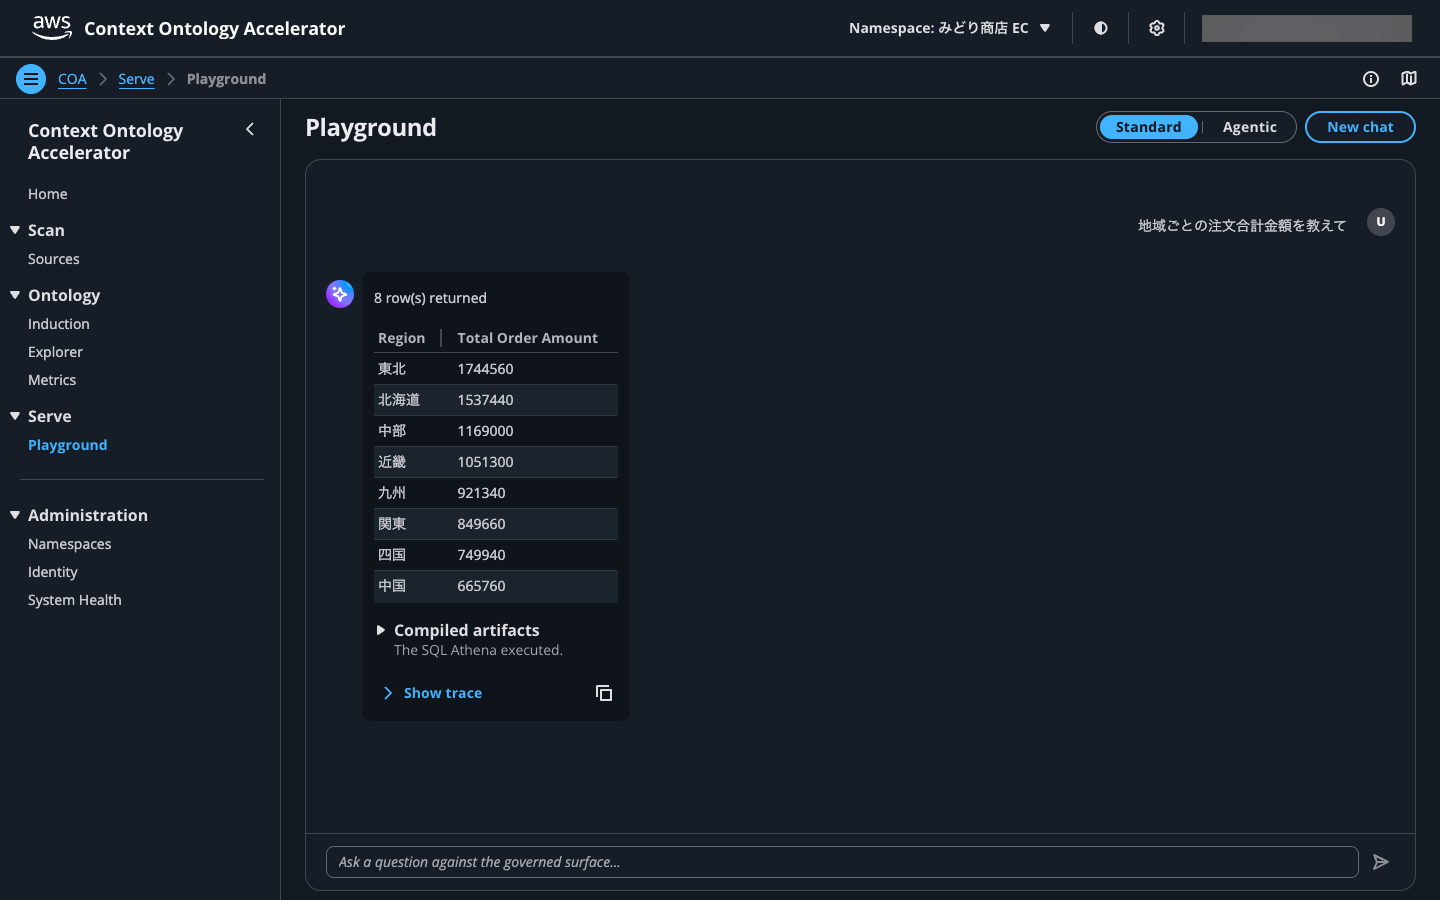
図23: 結果テーブルと実行 SQL が並んで表示される
ドキュメント知識の質問(Tier 3)では、回答に加えて引用元の文書が示されます。

図24: Tier 3 では引用元の文書付きで回答する
解決トレースで Tier の判定理由を確かめる
各回答には「Show trace」があり、押すと解決過程の内訳が開きます。Tier 構造を理解するのに最も役立つ画面です。
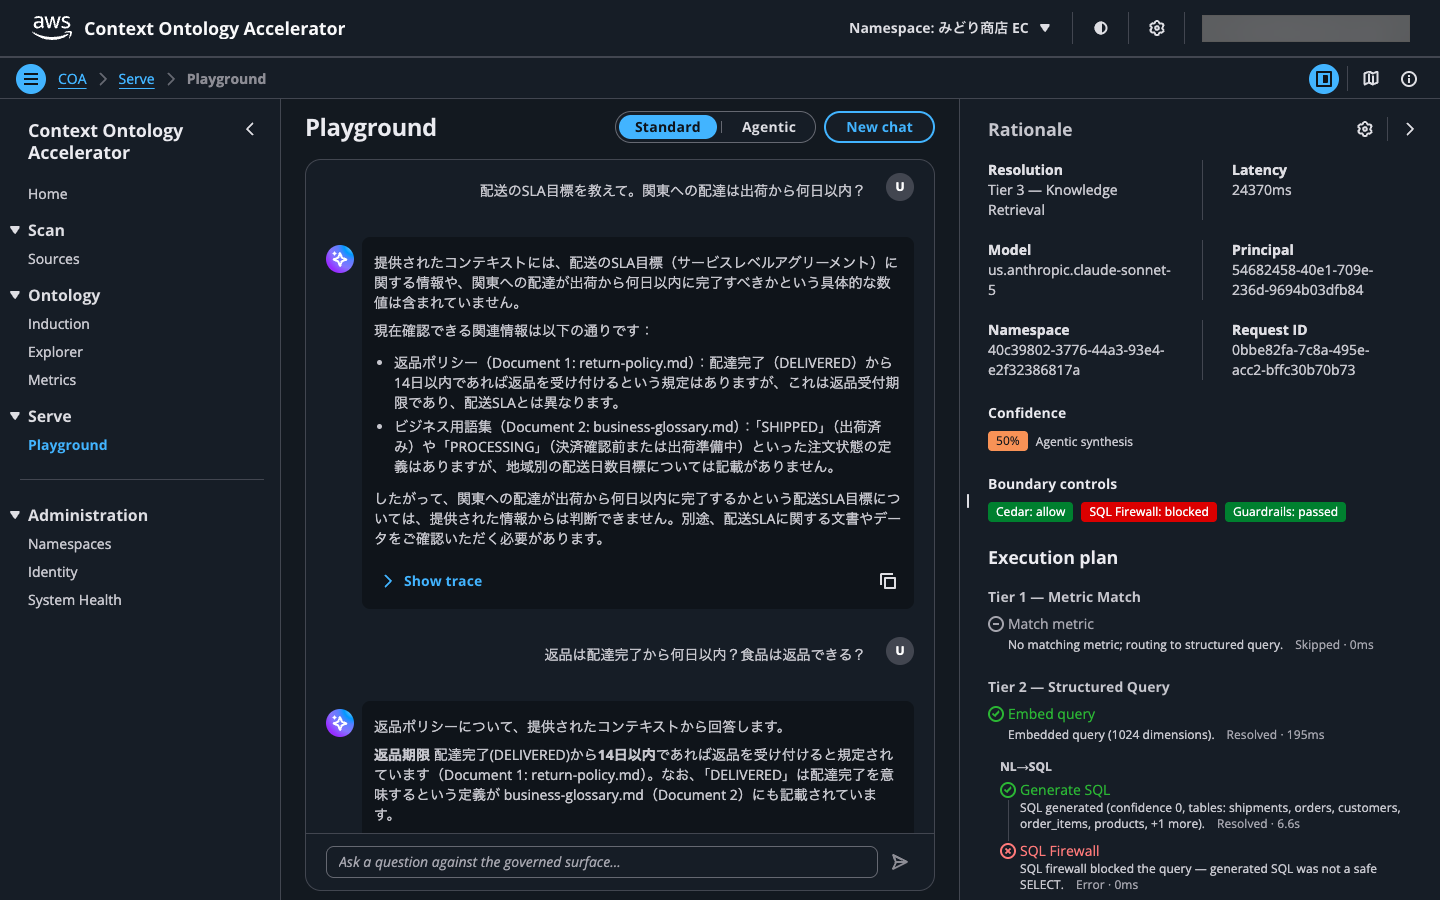
図25: トレースで Tier ごとの判定結果が見える
「Execution plan」に Tier 1 → 2 → 3 が縦に並び、それぞれ判定結果が書かれます。たとえば Tier 1 には次のように出ます。
No matching metric; routing to structured query.
「一致するメトリクスが無いので構造化クエリに回す」という判断が明示されているわけです。加えて Confidence(確信度とその根拠)と Boundary controls(ガードレールの適用状況)も表示されます。
どこで何が起きたかが全部見えるので、期待と違う答えが返ったときの切り分けが容易です。「Tier 1 で拾ってほしかったのに Tier 2 に落ちた → メトリクス定義か同義語を見直す」という改善サイクルが回せます。
なお REST API(POST /namespaces/{id}/query)には API Gateway の 29 秒制限があるため、解決に時間のかかる質問はタイムアウトすることがあります。Playground はストリーミング接続なのでこの制限がなく、重い質問は Playground かストリーミング API で投げるのが基本です。
Identity と Permissions で誰が何をできるかを管理する
アクセス制御は 2 層構造です。
- プラットフォームロール:
platform-admin/platform-viewer(全 namespace に効く) - namespace ロール: owner / maintainer / data-steward / data-analyst(namespace 単位)
Identity 画面でプラットフォーム全体のメンバーを管理します。
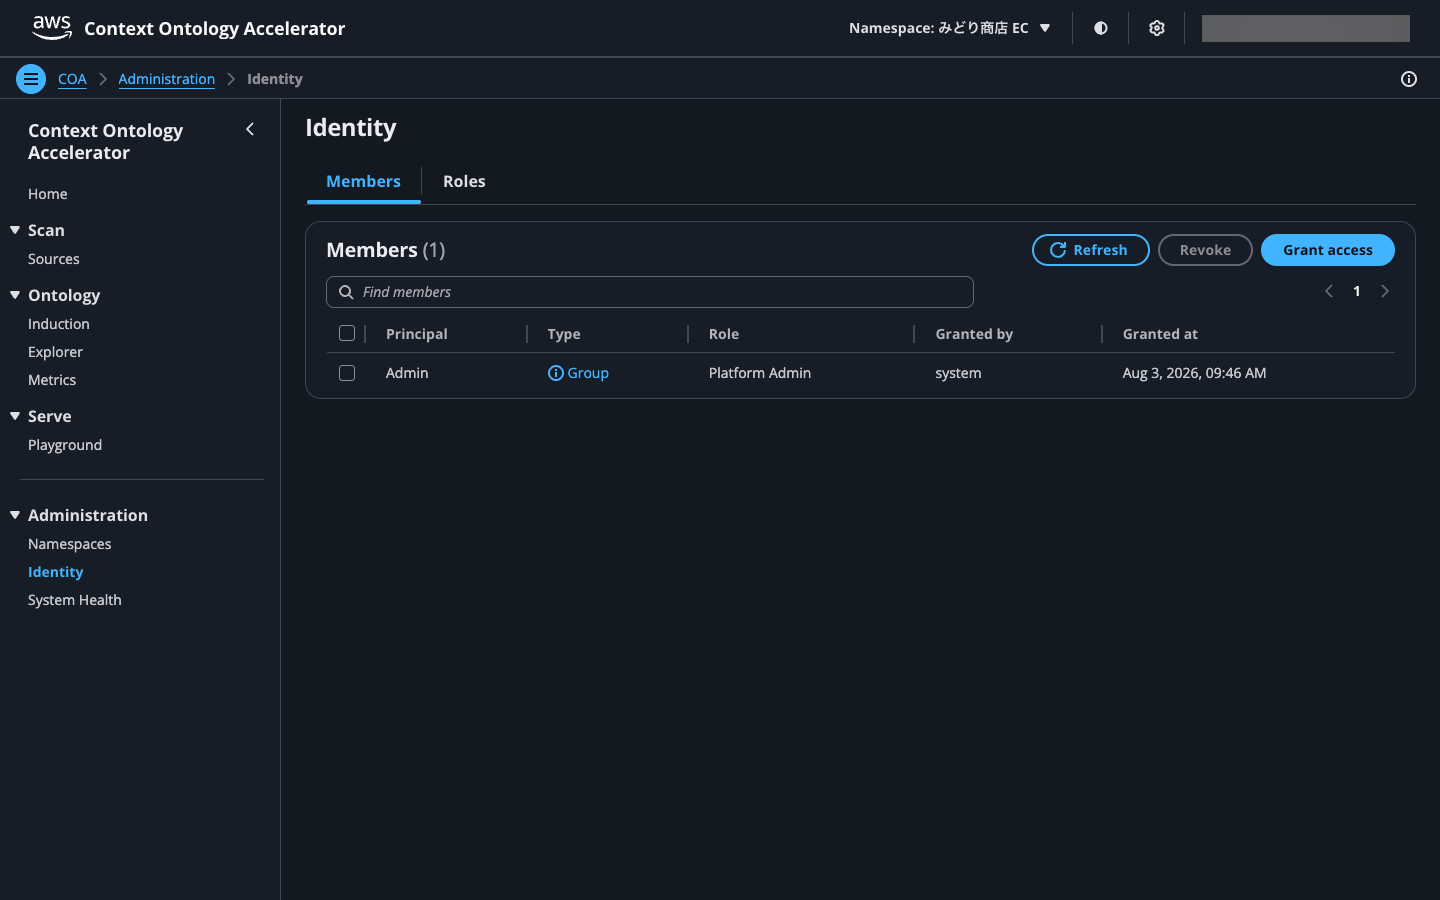
図26: プラットフォーム全体のメンバー管理
一方、namespace 側にも独立した Permissions 画面があります。こちらの方が粒度が細かく、実務で多用するのはこちらです。
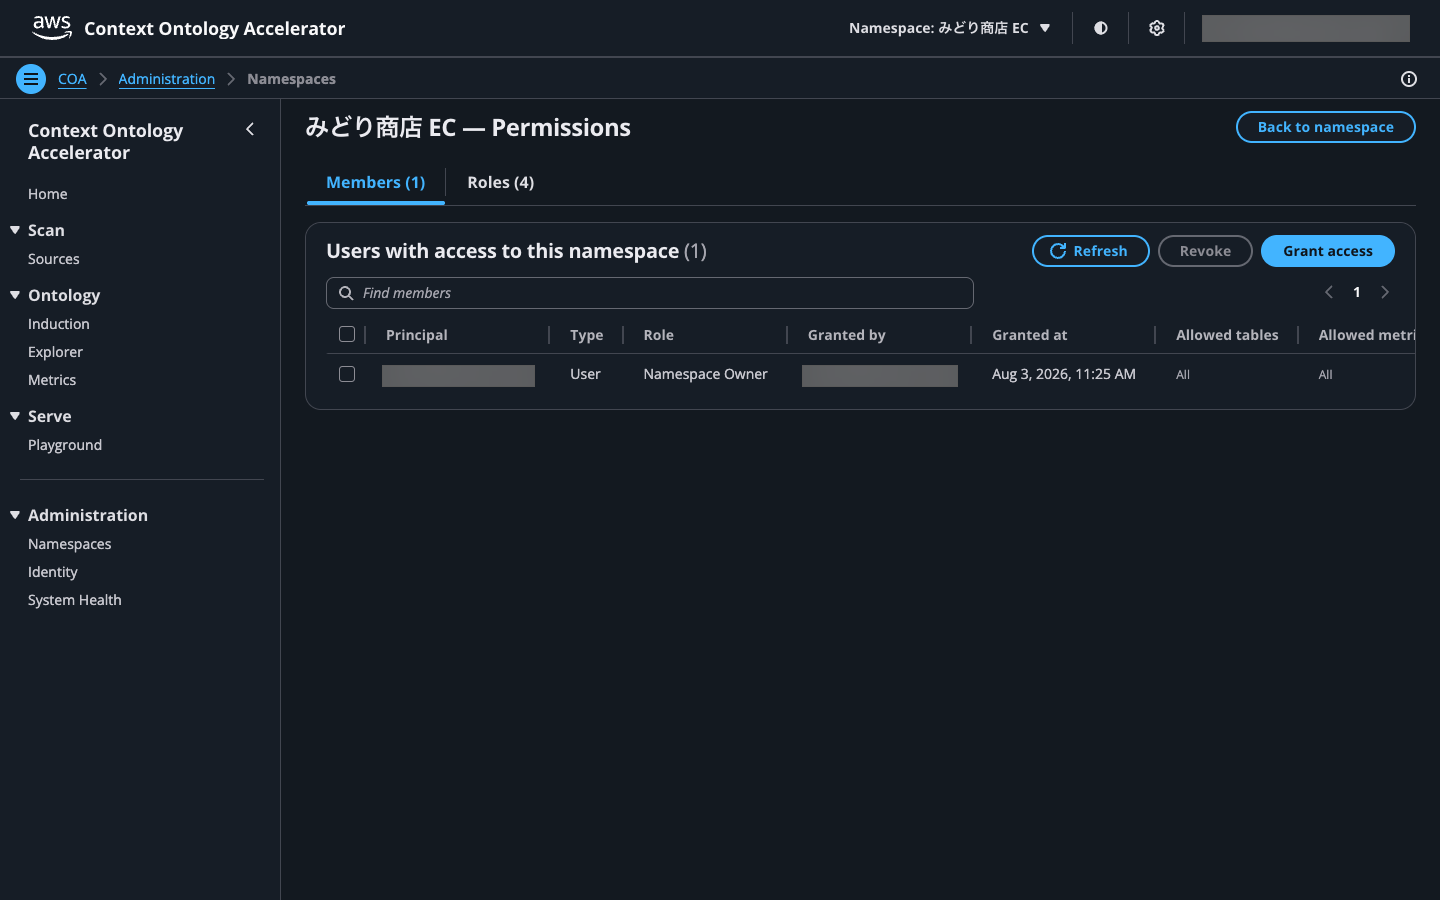
図27: テーブル・メトリクス・列単位で権限を絞れる
列を見ると制御の細かさが分かります。Allowed tables / Allowed metrics / Denied columns という列があり、ロールを付与するだけでなく「このユーザーはこのテーブルだけ」「この列は見せない」という行・列レベルの制御ができます。給与テーブルの特定列だけ隠す、といった要件に対応できる構造です。
「Granted by」「Granted at」が記録されるので、権限付与の監査証跡も残ります。認可はポリシー言語 Cedar で記述され、API のすべての操作がポリシー評価を通ります。
自分の権限を確かめる場所が Profile 画面です。今回は platform-admin と namespace 側の 2 ロールが付与されていました。
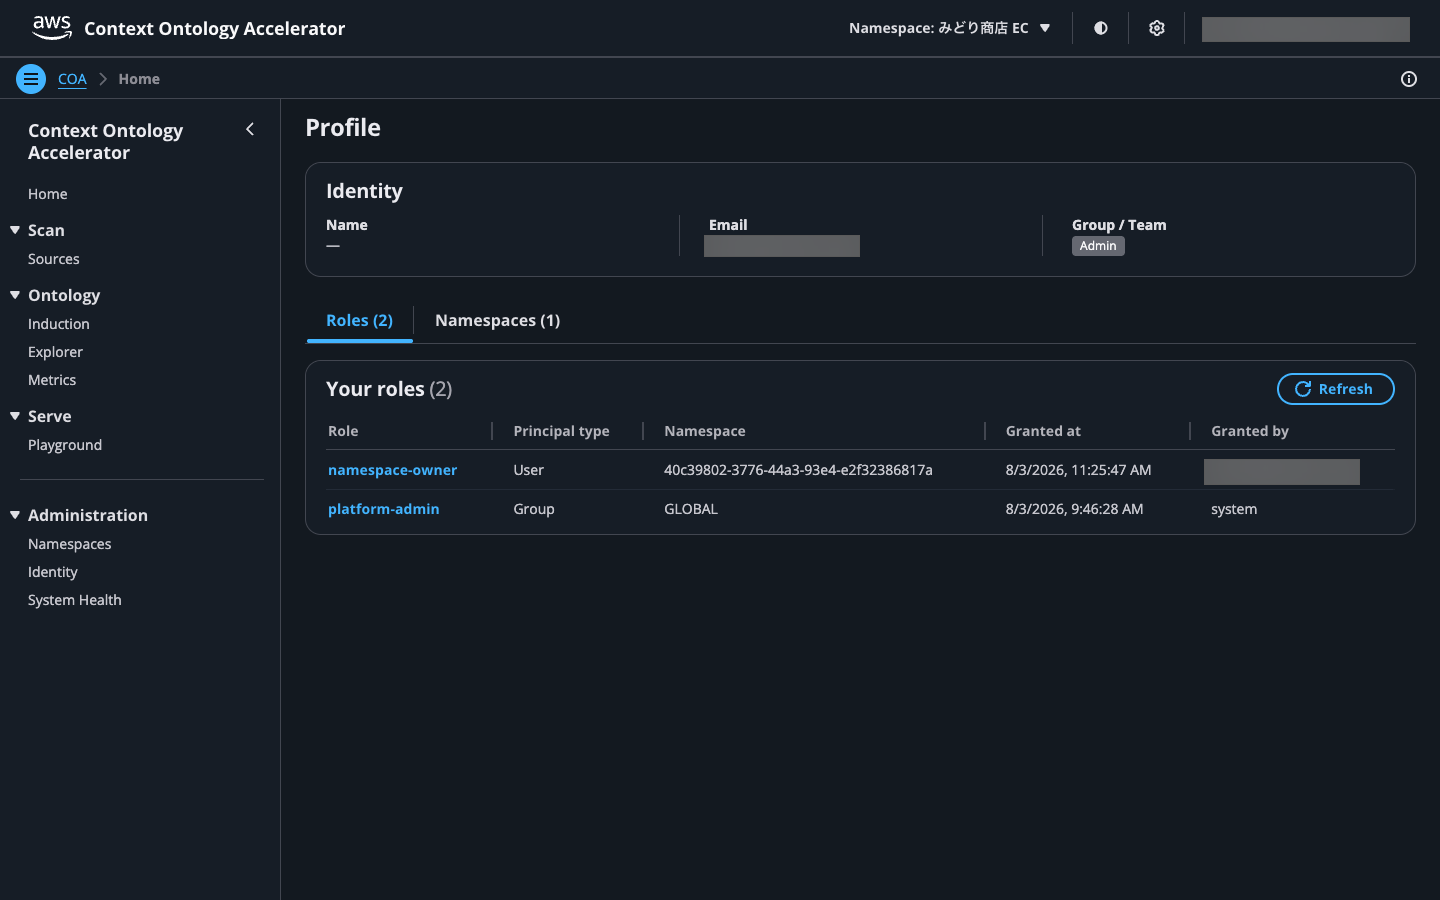
図28: 自分に付与されたロールの確認
System Health
各コンポーネントの稼働状況をまとめて確認できます。デプロイ直後や様子がおかしいときの最初の確認先です。
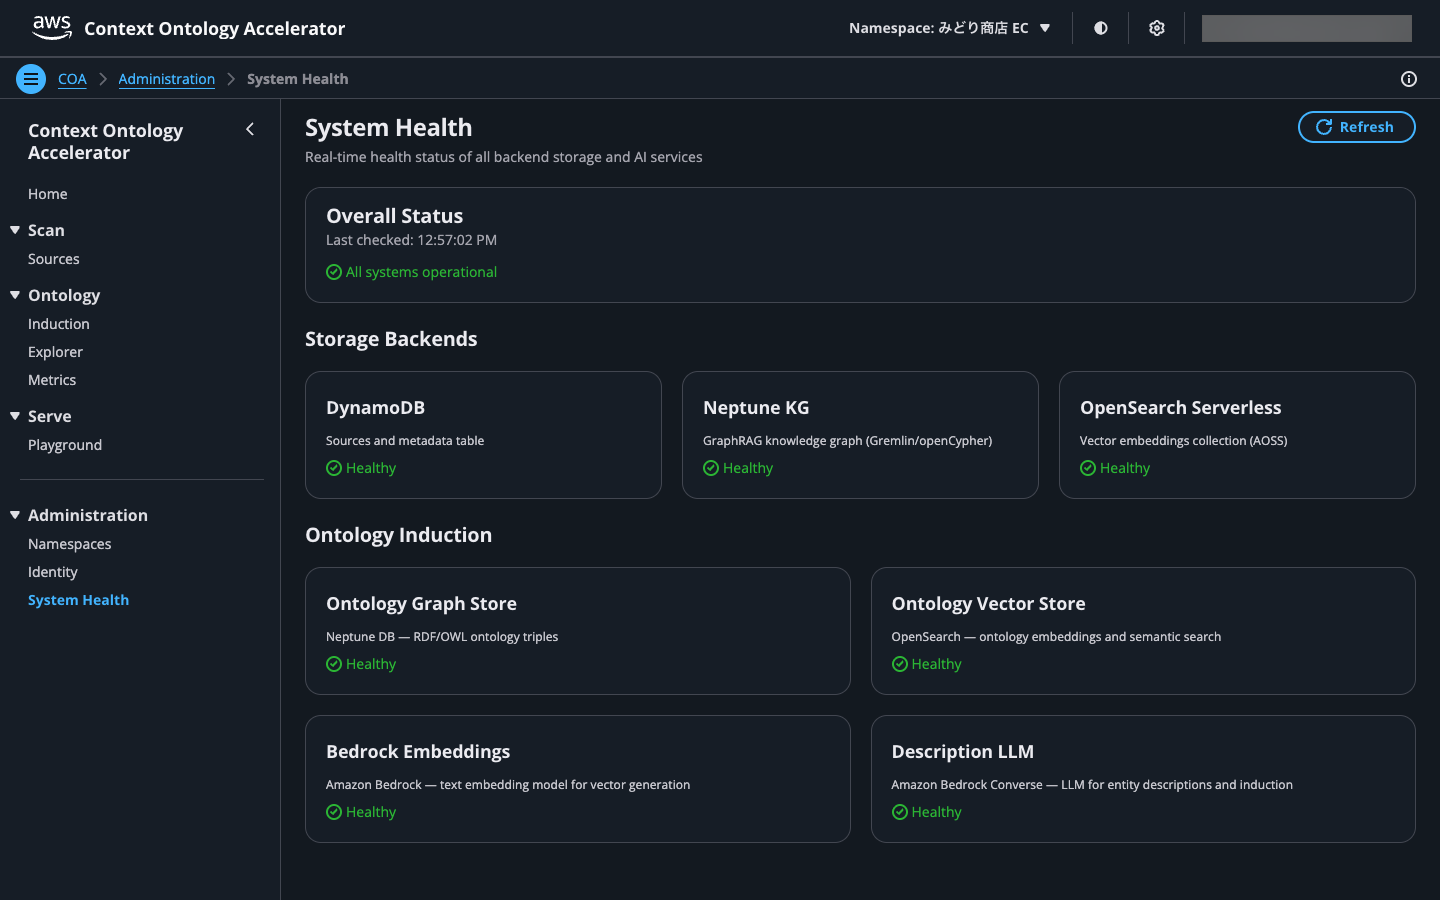
図29: 各コンポーネントの稼働状況
5. 実際に動かして分かったこと
Tier 1 の検証で「売上」の解釈が 53% ずれた
Metrics で total_revenue(配達完了注文の合計金額)を定義し、同じ「売上」を尋ねる 3 パターンで比較しました。この結果が、記事で一番伝えたい部分です。
| 質問 | Tier | 返ってきた金額 | 中身 |
|---|---|---|---|
total_revenue を教えて |
Tier 1 | 5,676,080 | 定義通り(DELIVERED のみ) |
| 総売上はいくら | Tier 2 | 8,689,000 | 全注文(キャンセル・未配達を含む) |
| 配達完了した注文の合計金額 | Tier 2 | 5,676,080 | 質問文に条件を明記したので正しい |
同じ「売上」という問いに対し、5,676,080 と 8,689,000 という 53% も違う答えが返りました。
Tier 1 でマッチしたときのトレースには matchSource: "name"、confidence: 1.0 と記録され、定義した SQL がそのまま実行されます。一方 Tier 1 を外れると Tier 2 が SQL を生成し、そこでは「売上」にキャンセル注文を含めるかという業務判断が LLM に委ねられます。今回は全注文を合計したので、経営指標としては誤りです。しかも SQL は文法的に正しく、結果も数字として自然なので、答えを見ただけでは間違いに気づけません。
これが冒頭で引用した dbt のベンチマークが「決定的な生成だから微妙に間違った結果を作れない」と表現していたことの実例です。ガバナンス済み指標を定義する価値が、数字で目に見えた形になりました。
Tier 2 では日本語の質問が JOIN 付き SQL になった
「地域ごとの注文合計金額を教えて」と日本語で聞くと、Tier 2 で解決され、次の SQL が生成・実行されました。
SELECT c.region,
       COALESCE(SUM(o.total_amount), 0) AS total_order_amount
FROM orders o
JOIN customers c ON o.customer_id = c.customer_id
GROUP BY c.region
ORDER BY total_order_amount DESC
オントロジーの関係(Orders --orders_customerId--> Customers)を正しく反映した JOIN です。「地域」という業務語彙が customers.region に、注文と顧客の関係が customer_id の JOIN に、それぞれ確定的に結びついています。答え合わせとして同じ集計を Athena に手書きで投げたところ、8 地域すべての数字が完全に一致しました。
この JOIN の根拠は、Glue には存在しなかった外部キーです。AI が推論し人間が承認した関係がオントロジーの object property になり、それが SQL の JOIN 条件になりました。Scan → Model → Serve が一本の線で繋がっていることが確認できました。
Tier 3 で見えた文書横断の回答と限界
「返品は配達完了から何日以内?」という質問は Tier 3 で解決され、「配達完了(DELIVERED)から 14 日以内」という正しい回答が return-policy.md の引用付きで返りました。
さらに、用語集(business-glossary.md)の「DELIVERED = 配達完了」という定義をクロス参照していました。「返品ポリシーの文書」と「用語集の文書」を繋いで答えているわけで、これはナレッジグラフを経由しているからこその挙動です。ベクトル検索単独では、こうしたマルチホップの参照は苦手な領域です。
一方で限界も見えました。同じ質問に「食品は返品できる?」を重ねたところ、return-policy.md に「食品カテゴリは返品不可」と明記されているにもかかわらず、「提供されたコンテキストからは判断できません」という回答になりました。検索がその箇所のチャンクを拾えなかったようです。
ただし、それらしい嘘をつかず**「分からない」と答えた**ことは評価できます。回答合成は取得できたコンテキストに厳密に紐づき、引用元も常に明示されます。検索リコールの限界は COA も例外ではありませんが、「間違えるより黙る」という設計は業務システムとして信頼できる振る舞いだと感じました。
全体の速度感と所感
| 工程 | 実測 |
|---|---|
| 16 スタックのデプロイ | 約 1.5 時間 |
| Glue 6 テーブルの Scan(discovery + AI エンリッチ) | 約 30 秒 |
| オントロジー生成(induction) | 約 30 秒 |
| 承認 → グラフ反映 | 1 分弱 |
| ドキュメント 3 本のナレッジグラフ構築 | 約 2 分 |
デプロイを除けば、データを繋いでから日本語で質問できるまで正味 10 分かかりません。「オントロジー整備は年単位のプロジェクト」という従来の感覚とは明確に違います。
オントロジーに対するハードルは、思ったより低かったのも発見でした。OWL や SPARQL を書く場面は一度もありません。やったことは「ソースを繋ぐ → 推論結果を承認する → 日本語で聞く」だけです。中身を理解していれば proposal の Turtle を直接編集できますが、必須ではありません。
日本語データはそのまま通りました。 日本語のテーブルコメント・データ値・質問文がすべて機能しました(生成されるクラス説明は英語)。日本語ドキュメントの取り込みと引用付き回答も問題ありません。
一方で押さえるべき前提もあります。構造化ソースを先に通さないと Tier 2 が使えない(ドキュメントだけでは is_mapped なクラスができない)、Neptune や OpenSearch Serverless など常時稼働リソースを多く抱える、といった点です。
6. どんな人が救われるのか
ここまでの解説と検証をふまえ、COA が有効なのはどういう状況かを整理します。
「Text-to-SQL の PoC は成功したのに本番化できない」データ基盤チーム
最も分かりやすく効果が出るのはここです。冒頭の Spider 2.0 の数字が示す通り、実企業のスキーマ規模では Text-to-SQL の精度が崩れます。原因が「言葉と列の結びつけ」なら、モデルを変えても解決しません。
COA は結びつけを、オントロジーと R2RML という明示的な資産にします。しかも生成は自動なので、数百テーブルに対して人間が手で書く従来のコストを払わずに始められます。PoC の壁が「精度」だったなら、有効な打ち手になり得る選択肢です。
「同じ指標が部署ごとに違う」を解消したいガバナンス担当
「売上」の定義が営業と経理で違う、という古典的な問題があります。第 5 章で見た「同じ質問に 53% 違う答えが返る」現象は、この問題が AI 経由で再生産された例です。指標を定義しないまま Text-to-SQL を業務に開放すると、部署ごとの解釈のズレがそのまま数字のズレになって出てきます。
COA では業務語彙とその定義が namespace 内の単一の資産に集約され、変更は proposal のレビューを通ります。誰がいつ何を承認したかは記録され、生成元(AI 生成 / 決定的 / 人間が編集)も列単位で残る形です。権限画面にも「Granted by」「Granted at」が記録されるため、監査証跡としても追跡できます。
「AI が起案し、人間が承認する」という流れが Scan にも Model にも一貫している点が、この用途では重要になります。メタデータ整備が「終わらないプロジェクト」になりがちなのは、最初の一歩の分量が多すぎるからで、AI に下書きさせて人間はレビューに専念する形は、その構造を変えるものです。加えて生成物を HermiT で機械検証できるので、レビューの負荷そのものも下がります。
「定義済み指標以外の質問に答えられない」BI・アナリティクス担当
メトリクス定義型のセマンティックレイヤーは、定義した指標については完璧に答えます。逆に言えば、定義していない切り口の質問には答えられません。「地域別売上」は定義済みでも、「初回購入から 30 日以内にリピートした顧客の地域分布」は定義していない、というケースです。
オントロジーは概念と関係のネットワークなので、定義済み指標に無い問いでもグラフを辿って組み立てられる余地があります。アドホックな分析要求が多い環境では、この表現力の差が現れます。
「テーブルと文書を跨いだ質問」に答える必要がある業務部門・サポート
実務の質問は、往々にして構造化と非構造化の両方にまたがるものです。「この注文はキャンセルできる?」は、注文テーブルのステータス(構造化)と、キャンセルポリシー(文書)の両方を見ないと答えられません。
COA は両方を同じグラフに載せ、同じ入口で聞けるようにします。これはメトリクス系のセマンティックレイヤーには無い性質で、検証でも用語集と返品ポリシーを繋いで答える挙動が確認できました。カスタマーサポートの一次回答支援や、社内ヘルプデスクのようなユースケースと相性が良さそうです。
「エージェントに正しいコンテキストを渡したい」エージェント開発者
COA は MCP サーバーを提供するので、Kiro や Claude Desktop のようなクライアント、あるいは自作エージェントから「ガバナンスされたコンテキスト」を取得できます。エージェントが独自にスキーマを推測してクエリを組むのではなく、承認済みの意味の層を経由させる構成が取れます。
is_mapped のように「データの裏付けが無い概念には SQL を書かせない」という制御が仕組みとして入っている点も、エージェントの想定外の動作を抑えるうえで有効です。
逆に、あまり救われないケース
一方で、次のようなケースには向きません。
- 単一 DB への単純な Text-to-SQL で足りる場合: テーブル数が数十で語彙も素直なら、そのまま LLM に投げた方が早くて安いです。COA は Neptune や OpenSearch Serverless を含む構成なので、規模に見合わない投資になります
- すでに単一ウェアハウスに寄せている場合: Snowflake や Databricks の内蔵セマンティック機能で足りるなら、そちらの方が運用は軽いです
- オントロジーのレビューを担う人がいない場合: COA の設計は「人間が承認する」前提です。承認を無条件に通す運用にすると、AI の推論結果がそのまま資産になってしまい、仕組みの利点が消えます
7. 他の選択肢との違い
2026 年前半は「AI に意味を渡す層」の整備が各社で進んでいます。COA の位置づけを整理します。
| アプローチ | 表現するもの | 構造化 / 非構造化 | 特徴 |
|---|---|---|---|
| ウェアハウス内蔵型(Snowflake Semantic Views、Databricks Metric Views など) | メトリクス・ディメンション・JOIN 定義 | 構造化中心 | そのウェアハウスに密結合。単一プラットフォーム運用なら最短距離 |
| 独立セマンティックレイヤー(dbt Semantic Layer、Cube など) | メトリクス定義 | 構造化中心 | ベンダー中立、複数ウェアハウス対応 |
| COA | 形式オントロジー(OWL)+ ナレッジグラフ(概念・関係・制約) | 両方を同一グラフに | OBDA + LLM 自動生成。推論器による整合性検証。AWS 上で自己ホスト、OSS |
差分として大きいのは 2 点です。
1 つめは表現力です。メトリクス定義が答えるのは「その指標をどう計算するか」ですが、オントロジーは「概念どうしがどう繋がっているか」「どんな業務ルールがあるか」まで表現します。反面、指標の一貫性を最速で保ちたいだけなら、メトリクス定義の方が軽量です。
2 つめは構造化と非構造化の統合で、前述の通り、テーブルと文書を同じ入口で聞ける点は他にあまり見かけません。
なお AWS は 2026 年 6 月の AWS Summit New York で、組織のデータからナレッジグラフを構築してエージェントに提供する AWS Context というマネージドサービスを発表しています(AWS の発表、解説記事)。同じ課題領域にマネージドの選択肢も登場しつつある状況です。COA は自分のアカウントに立てて中身のコードまで確認できる OSS という位置づけで、要件に応じた作り込みや、このアプローチが自社データで機能するかの検証に向いています。
付録: デプロイで詰まった点
実際にデプロイして詰まった箇所を共有します。COA 固有の話は少なく、多くは環境側の問題でした。
git clone https://github.com/aws/context-ontology-accelerator && cd context-ontology-accelerator
make setup        # uv sync + pnpm install + Smithy codegen
make deploy-dev   # preflight → build → cdk deploy --all
Java 17 が必要: COA は API 契約を Smithy で定義し、OpenAPI / Python / TypeScript クライアントを生成します。このビルドに Java 17+ と Gradle が要ります。mise なら mise use -g java@temurin-17 の一行です。
Finch を使う場合は ECR 認証方式に注意: Docker Desktop の代わりに Finch を使う場合、COA の preflight が Finch を自動検出してくれますが、イメージ push で no basic auth credentials になりました。原因は ~/.finch/config.json の credsStore: osxkeychain で、認証トークンが macOS Keychain に入るため、Lima VM 内で動く finch push から読めません(finch login 自体は成功と表示されるため気づきにくい)。credsStore を外して再ログインすると通ります。
aws ecr get-login-password --region us-east-1 \
  | finch login --username AWS --password-stdin <ACCOUNT_ID>.dkr.ecr.us-east-1.amazonaws.com
chmod 600 ~/.finch/config.json   # トークンが平文で載るので権限を絞る
まとめ
AI エージェントが業務で外す原因は、モデルの賢さではなく「渡している情報に業務の意味が無い」ことでした。だからこそ 2026 年のデータ業界は意味の層の整備に一斉に動いており、COA はその中で形式オントロジー + ナレッジグラフという表現力の高い選択肢を、OBDA という確立された枠組みと LLM の自動生成で実用ラインに乗せた OSS です。
オントロジーは SQL を書くための道具ではなく、意味の相互運用・推論・制約検証・知識の共有を担う知識表現の枠組みです。本記事で見た Text-to-SQL はその応用の一つで、実際の COA も推論器による整合性検証、SHACL 制約、標準オントロジーへのグラウンディング、文書横断のグラフ探索といった SQL 以外の面でオントロジーを活かしていました。
実際に動かしてみて印象的だったのは 3 点でした。Glue に無い外部キーを AI が推論し、それが SQL の JOIN として機能したこと。構造化データと文書を同じ入口で聞け、文書どうしを跨いで答えたこと。そして「分からない」と正直に答えたことです。
「オントロジー」という言葉の重さに反して、実際の体験は「つないで、承認して、聞く」だけでした。この層が何を解決するのかを理解するには、サンプルデータで一度動かしてみるのが一番早い方法です。
参考リンク
- Context Ontology Accelerator (GitHub)
- Spider 2.0 — 実企業データベースの Text-to-SQL ベンチマーク
- Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update (dbt Labs)
- Ontop — OBDA / Virtual Knowledge Graph システム
- Retrieval-Augmented Generation of Ontologies from Relational Databases (RIGOR)
- R2RML: RDB to RDF Mapping Language (W3C)
- AWS Summit New York 2026 — AI エージェント関連の発表
- Cedar Policy Language

この Publication に投稿している記事は、アマゾン ウェブ サービス ジャパン合同会社または Amazon Web Services, Inc. 所属社員による個人の見解であり、所属する組織の公式見解ではありません。参加したい従業員の方は、Hikoto Iseda までお知らせください。
Discussion