


本地运行的 AI 声音工作台 —— 语音克隆、音色设计、多角色剧本演播与口播配音。
一条命令合成音频,不联网、无需商业 API Key、私密音频永不离机。
面向创作者、声音设计师,以及 AI / Agent 自动化工作流。
快速开始 · 核心命令 · 语音后端 · Web 工作台 · Agent 调用

| 特性 | ElevenLabs / 商业云 | 剪映配音 / 在线平台 | VoxFlow 声流 |
|---|---|---|---|
| 音频隐私安全 | ❌ 必须上传云端 | ❌ 依赖平台服务器 | 🛡️ 全程本地运行,绝不出机 |
| 声音克隆 | ❌ 不支持自定义 | ✅ 一段 5~10 秒样音即刻克隆 | |
| 文字描述造音色 | ❌ 无此能力 | 🎨 无需参考音,一句话提示词凭空捏音 | |
| 持续使用成本 | 💸 按 Token/字符持续扣费 | 🔒 绑定特定生态 | 🎁 一次部署,永久免费 |
| 音乐与发行 | ❌ 混杂在一起 | ❌ 仅限内置分发 | ➡️ 音乐生成与发行已完全独立到 suno-publisher |
| 开发与自动化 | ✅ REST API | ❌ 封闭 GUI | ⚡ 统一 CLI + FastAPI 后端 + Agent Skill |
| 成本与用量可见 | ❌ 只给账单总额 | ❌ 无 | 📊 本地免费折算 · 实测用量统计 · 服务体检 |
git clone [email protected]:webkubor/voxflow.git
cd voxflow

# --skip-models:先不下 5.8 GB 模型,装完就能开工
chmod +x install.sh && ./install.sh --skip-models

source .venv/bin/activate
voice doctor # 环境自检voice web
# → 浏览器访问 http://localhost:8866不用等模型下完才开始。 本地 TTS 的模型权重有 5.8 GB(MLX 8-bit),但 VoxFlow 里 不碰本地模型的功能占了一部分:
| 立刻可用(零下载) | 需要 Base 模型(2.9 GB) | 需要 VoiceDesign(2.9 GB) |
|---|---|---|
| 原创存证 / 媒体资产库 | 声音克隆 / 文本配音 | 一句话凭空捏音色 |
| 运营台(成本 / 健康 / 日志) | 多角色剧本演播 |
想用配音或克隆时点进去,那一屏有张卡可以就地开始下载(后台跑, 关掉页面也不中断),并列出这期间照常能用的功能。
也可以一次装到底:
./install.sh                        # 交互式,问你要不要下 VoiceDesign
./install.sh --yes                  # 无交互,两个模型都下(CI / Agent)
./install.sh --yes --skip-voice-design   # 只下 Base,省 2.9 GB
模型下到
~/.voxflow/models-mlx/(数据目录),不是项目目录 —— 重装工具、换分支、git clean都不会让你重下一遍 5.8 GB。2026-09-14 之前下的是 Qwen 原生 PyTorch 权重(
~/.voxflow/models/,8.4 GB)。 那套现在已经没有代码读取,留着只是为了回滚;确认 MLX 版稳定后可以自行删除腾空间。
VoxFlow 提供现代化 Typer CLI 工具链,支持本地音频处理全流程:
使用已有音色角色合成台词文本,产物落在数据目录的 out/:
# 基础克隆:音色取自该角色在 personas.json 里登记的参考音频
voice clone narrator "霜叶红于二月花,山色空蒙雨亦奇"
⚠️ --tone/--emotion在克隆路径上不生效。 MLX 的 Base 模型在源码层 就没有动态情绪指令的入口(PyTorch 时代的instruct_ids是真生效的,迁移后 没有等价实现)。要带情绪就把情绪写进文本本身(「他愤怒地吼道:……」), 或改用下面的音色设计 —— 它走 VoiceDesign,原生支持指令。 传了--tone时 CLI 会明确告诉你「本次不会生效」,不会静默吞掉。
无需任何参考音频,仅通过自然语言描述创造专属音色:
# 通过文字描述设计新音色并入库
voice design sword_master "十步杀一人,千里不留行。" --tone "苍劲豪迈的江湖侠客,沉稳威严"根据剧本配置文件一键批量合成完整对话音轨:
voice dialogue configs/dialogue.jsonvoice voice list # 查看本地所有已注册音色
voice voice add my_voice sample.wav --ref-text "录音里实际说的完整短句" # 注册完整参考音频与原文
voice voice preview narrator # 试听音色预设样音
voice voice rm old_voice # 删除指定音色录音或导入参考音频时,填写与声音逐字对应的「录音原文」。建议 3–15 秒,接受 0.5–30 秒、最大 20 MB;整句保留,不截掉开头。音频与原文仅保存在本机。设计音色入库会自动保存生成时的文本。已有音色不被迁移或覆盖。
API:POST /api/personas/add 的 multipart 字段为 key、name、audio、必填 ref_text,可选 instruction;重复 key 返回 409。GET /api/personas 返回 capabilities.reference_text_registration=true。旧调用方需补传录音原文,不能把目标配音文本当成参考原文。
voice stats                    # 近 30 天:钱花在哪、本地跑省下多少
voice stats --tracks           # 按作品拆分:每首歌成本 + 回本播放数
voice stats --json             # 结构化输出,供 agent 判断「还要不要继续跑」
voice logs --level error # 只看失败的调用(失败照样扣上游积分)VoxFlow 的 TTS 在 2026-09-14 从 PyTorch(MPS) 迁到了 Apple MLX,模型换成
mlx-community 的 8-bit 量化版。这不是「换个库」,它把一类静默故障从架构上消掉了。
| 指标 | PyTorch + MPS(迁移前) | Apple MLX 8-bit(现在) | 变化 |
|---|---|---|---|
| 模型体积(Base + VoiceDesign) | 8.4 GB | 5.8 GB | ⬇ 省 31% |
| 单次推理 | 9.32 s | 5.29 s | ⬆ 快 1.76× |
| 输出时长(同文本同音色) | 4.64 s | 4.56 s | 一致 |
| 音质(whisper 转写回读) | 一字不差 | 一字不差 | 无损失 |
| 峰值内存 | — | 6.97 GB(实测) | — |
| 模型加载 | 14.44 s | 6.55 s 冷 / 5.74 s 热 | 首次冷读盘偏慢 |
快的原因不是「MLX 天生快」。 PyTorch 那版靠一行
PYTORCH_ENABLE_MPS_FALLBACK=1 才跑得起来 —— MPS 不支持的算子会静默回退到
CPU,中间还要把张量搬回来,「统一内存」在这一步被浪费,而外部完全看不出来。
MLX 没有 fallback:要么全走 Metal GPU,要么报错,不存在静默降级。
这才是迁移的根本收益,省 31% 体积只是顺带的。
用 Qwen3-TTS 自带的 speaker encoder(x-vector)算余弦相似度,带负对照(另一个 音色作下界)并测噪声底(同后端换 seed,看相似度自己抖多少):
| 对象 | 与原音色的余弦相似度 |
|---|---|
| 参考音频自比(上界) | 1.0000 |
| PyTorch seed 42 / 43 / 44 | 0.9931 / 0.9928 / 0.9925 |
| MLX | 0.9934 |
| 负对照 · 另一个音色(下界) | 0.9425 |
PyTorch 三个 seed 的极差(噪声底)= 0.0006,MLX 与 PyTorch 均值之差 = +0.0006
—— 恰好落在噪声底上。所以迁移在音色上既没有损失也没有收益,别拿它当补偿项。
复现脚本:tools/compare_voice_fidelity.py。
1. 克隆路径没有动态情绪指令。 MLX 的 Base 模型在源码层就没有 instruct 入口
(_generate_icl() 签名里没有该参数)。而 PyTorch 时代的 instruct_ids 是
真生效的 —— 控制变量实测(固定 seed、只切这一个参数)输出完全分叉:
F0 变异系数 +33.9%、F0 动态幅度 +49.9%、能量动态幅度 +136.5%,正是情绪唤醒的声学
特征。所以这是净损失,不是「本来就没用」。替代方案:把情绪写进文本,或走
VoiceDesign。复现脚本:tools/verify_instruct_effect.py。
2. ref_text 必填。 克隆时参考音频对应的文本要填在 personas.json 的
ref_text 字段里,留空会截断 + 乱码:
ref_text |
产出时长 | whisper 转写 |
|---|---|---|
""(错) |
2.08 s(截断) | 「这是一字语音色争要了根根」❌ |
| 真实文本(对) | 4.56 s | 「这是一次语音合成测试,用来验证模型能否正常工作。」✅ |
缺这个字段时 CLI 会直接报错、并告诉你该拿 whisper 转写哪个文件,不会丢一段乱码给你。
Apple Silicon(M 系列)+ macOS,没有例外。 PyTorch 回退链路已整个删除
(留着等于每次改代码维护两套、A/B 跑两遍)。
voice doctor 在非 Apple Silicon 上会直接 FAIL 而不是 WARN ——
「不能用」不该被写成「差一点」。
决策过程、能力矩阵、全部改动清单与回滚方法见 docs/MLX_MIGRATION.md。
除命令行和浏览器界面外,VoxFlow 也提供基于 MyGo + WKWebView 的原生 macOS 窗口,复用同一套本地前端和 Python/MLX 后端。音色、模型、数据库和输出仍保存在 ~/.voxflow/,CLI 与 App 共用;App 不会另建一份资源库。

# 在项目根目录构建并安装到 ~/Applications
./desktop/build.sh
首次使用前先按 CLI 安装说明配置 Python 环境和 MLX 模型。桌面 App 启动时会复用已运行的本地服务,或尝试从构建时记录的项目路径启动 run.sh;项目目录移动后,重新运行构建脚本。App 提供原生「工作区」菜单和打开数据/输出目录的快捷入口。
VoxFlow 内置高对比、纯净深色的现代音频创作界面:
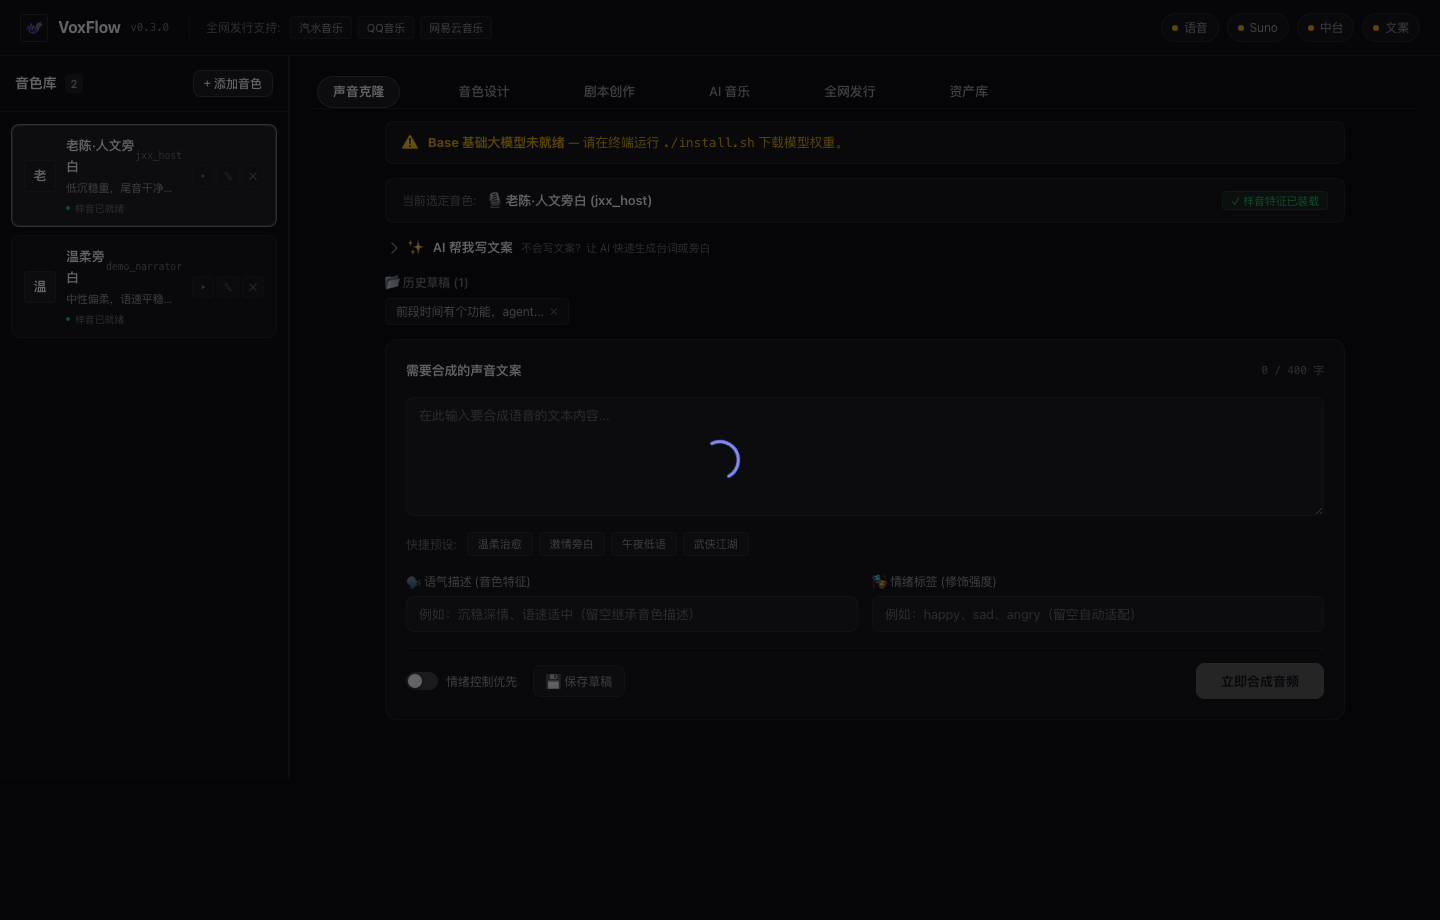
- 音色工坊:左侧统一管理所有已装载的音色艺人,支持快捷试听波形律动与样音状态。
- 创作控制台:包含快速氛围预设(温柔治愈 / 激情旁白 / 午夜低语 / 武侠江湖)、情绪优先级控制与草稿箱管理。
- 原创存证:导出创作留痕(提示词、生成参数、选了哪一版、音频指纹)并做区块链存证。
- 媒体资产库:历史音频一键在线试听、波形查看与批量物理下载。
- 全定制纯净播放器:完全剔除原生浏览器控件,提供极细时间轨、高精度拖拽定位与无损播放。
- 成本与健康:生成成本、用量、服务健康、运行日志四合一 —— 见下一节。
发行(汽水 / QQ / 网易云上架、专辑、平台账号)已于 2026-10-10 迁往 suno-publisher,本仓不再包含发行界面。
大多数 AI 创作工具只告诉你「生成成功」。VoxFlow 还告诉你这次生成花了多少、 这首歌播多少次回本、到今天为止是赚还是赔。
访问 http://localhost:8866/#/ops,或跑 voice stats。
| 上游 | 计费方式 | 在账上怎么体现 |
|---|---|---|
| 本地 TTS(Qwen3-TTS) | 免费 | 实付永远 ¥0,同时折算出「同样的量走商业 API 要多少」 |
| museav 中台(出图 / 辅写) | 预付积分 | 按 token / 张数计量,走 voice museav login 授权,花的是你自己账户的积分 |
两个容易被忽略、但这里特意做了的细节:
- 成本在写入时按当时单价定格。换套餐、中台调价,都不会回溯改写历史账目。
- 单价表在
configs/pricing.json,复制到~/.voxflow/configs/即可覆盖,升级不会被冲掉。
VoxFlow 现在是纯粹的声音工作台(专注于本地 TTS、音色设计、声音克隆与剧本演播)。
所有 AI 音乐生成(Suno 直连) 以及 全网发行(汽水音乐 / 网易云 / 腾讯音乐人 上架自动化与收益台账) 已彻底收敛独立至: 👉 suno-publisher —— 独立仓库、独立数据库、独立全链路 Ego lite 自动化,自给自足一条龙。本仓不再包含任何音乐生成逻辑。
VoxFlow 原生面向自动化 Agent 体系设计:
./install.sh --yes                      # 全自动安装:依赖 + Base + VoiceDesign 模型
./install.sh --yes --skip-voice-design # 仅装依赖与 Base 模型(省 2.9GB)voice doctor # 终端表格检查报告
voice doctor --json # 输出 JSON 格式供 Agent 决策解析voxflow/
├── cli/ # Typer CLI 命令入口 (clone / design / dialogue / web / doctor 等)
├── core/ # 核心业务引擎 (克隆器 / 提示词设计 / 数据库 / 管道分发 / 计量 obs.py)
│ ├── paths.py # 路径真源 —— 代码在哪、数据在哪,全项目只在这里定义一次
│ └── engine.py # Qwen3-TTS 引擎(Apple MLX 8-bit,见 docs/MLX_MIGRATION.md)
├── web/ # FastAPI 后端路由与静态服务
│ ├── app.py # RESTful API 端点 (合成、音色、艺人档案、任务队列、健康/指标/成本)
│ └── ui/ # Vue 3 + Pinia + Vite 现代纯黑工作台前端源码
├── configs/ # 平台 SOP、单价表 (pricing.json) 及初始配置
├── tools/ # 一次性验证脚本 (MLX 冒烟 / PyTorch 基线 / 音色还原度 / 内存探测)
├── docs/ # 文档索引见 docs/README.md
├── tests/ # 计量逻辑自检(无框架,python tests/test_obs.py 直接跑)
└── assets/ # 品牌图标与官方工作台截图
本项目采用 Apache-2.0 许可证开源。 底层语音建模基于 Qwen3-TTS 深度定制开发,推理权重使用 mlx-community 的 12Hz-1.7B 8-bit 量化版。